[分享创造] Java 序列化丢进 Redis,怎么直接看对象
Java 序列化丢进 Redis ,怎么直接看对象
种种原因 Java 服务写进 Redis 的值,经常没法直观阅读,常见几种:
- JDK 原生序列化(
ObjectOutputStream)—— 开头一串¬í/ac ed,后面全是二进制 - 带着转义的 JSON / 文本 —— Redis 里实际存的是
\x、\u、控制字符转义后的串 - Jackson / Fastjson 多态 JSON ——
@type/@class写在 JSON 里,结构对业务很重要 - 改完要写回去 —— 缓存一改错,联调现场就炸
官方工具 RedisInsight 很强:Workbench 、模块支持、官方背书都在。但对上面这几类 Java 研发日常排查,体验往往停在「能看到原始字节 / 原始字符串」
下面按这四个点,对照 RedisInsight 里大概长什么样,以及 RedisViewer 针对性的增强。
1. JDK 序列化:能不能直接看成对象树
业务里很常见:RedisTemplate 默认 JDK 序列化、老项目 setObject、Session / 本地缓存对象直接塞进 Redis 。
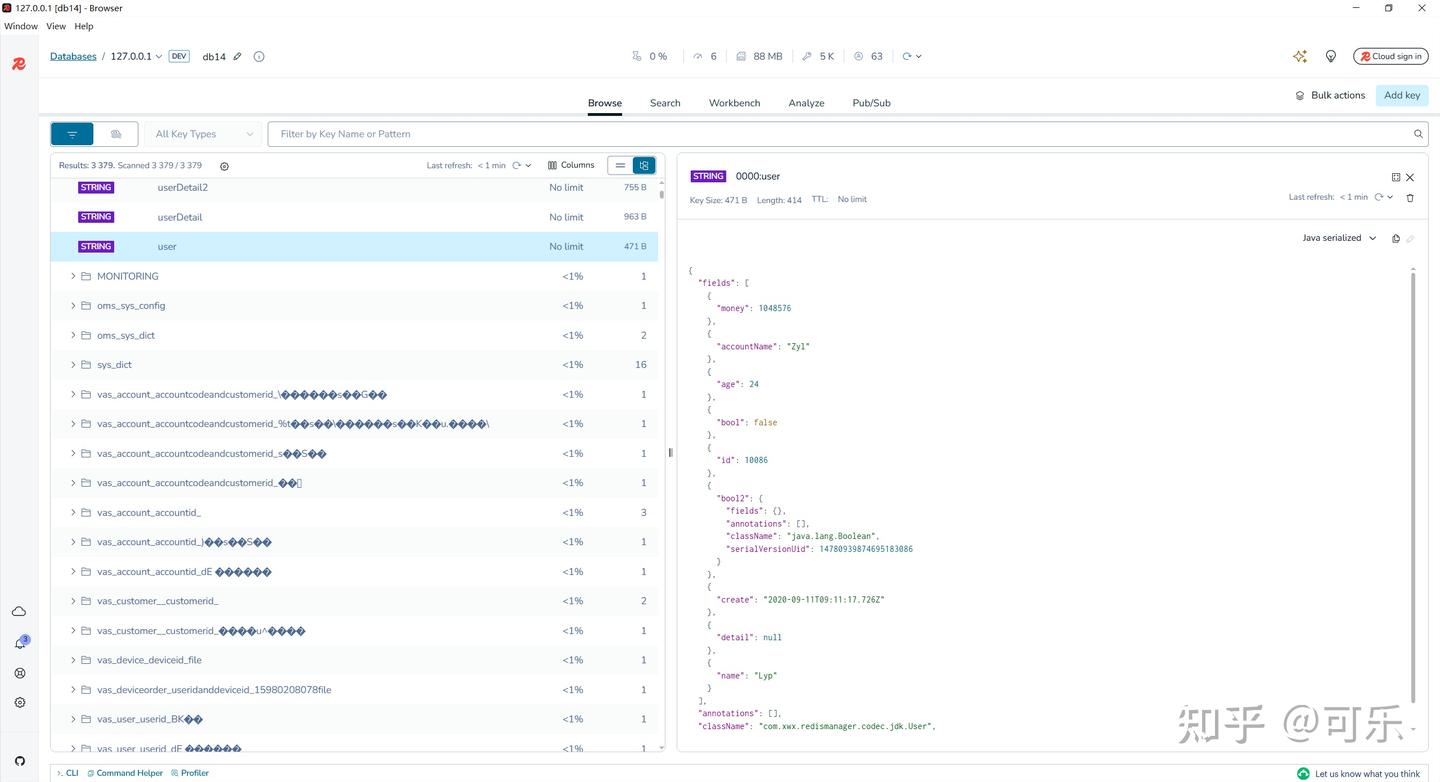
RedisInsight 上通常是什么样
打开 Key 后,值区多半是这样的:
- 大量信息缺失:各字段类型、属性从属结构关系等
- 排版简单,不方便阅读,与 Java 对象相去甚远
- 需要充分对照原 Java 对象进行脑补,甚至得自己写一小段 Java / 脚本反序列化,才能确认字段对不对
排查问题或故障时,成本偏高。
RedisViewer 这边
检测到 Java 序列化字节后,自动切换到 Java 查看器,按对象树展开:
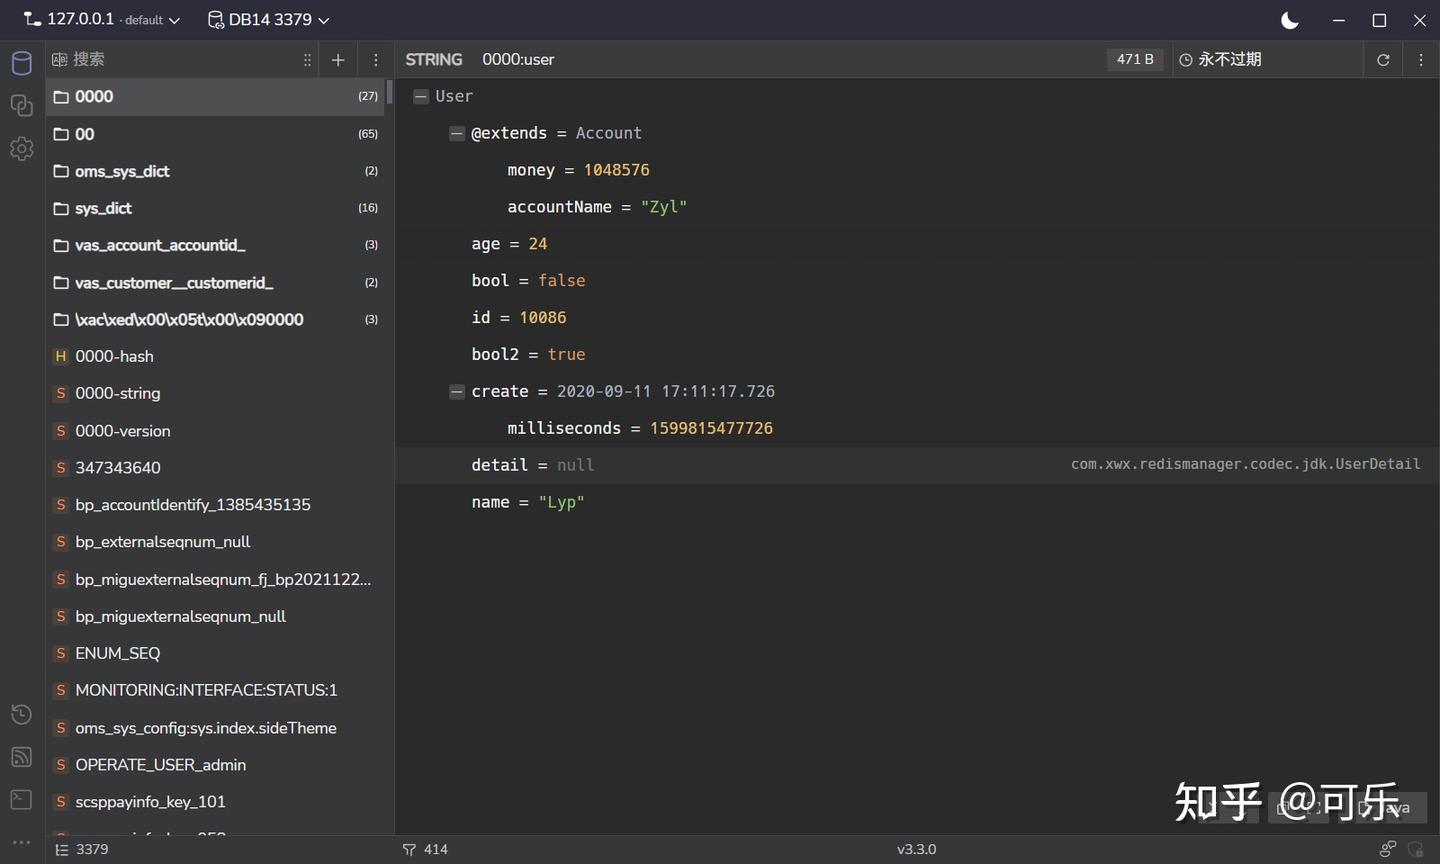
- 类名可读(含数组、集合、枚举等常见形态)
- 字段逐级展开 / 折叠
- 日期、装箱类型、UUID 、部分并发原子类等会尽量格式化成可读值
- 需要时仍可回到 Raw / Hex / Base64 看原始内容
目标是:联调时直截了当看清对象长什么样,不写脚本临时解析。
2. 转义字符串:存进去的和「看起来」的不是一回事
有些框架 / 中间层会把内容以 转义形式 写进 Redis (控制字符、\xHH、\uXXXX 等)。用普通 GUI 打开时:
- 要么一整行转义串,眼睛累、不好改
- 要么直接当普通文本,改完写回格式对不上
RedisInsight 上通常是什么样
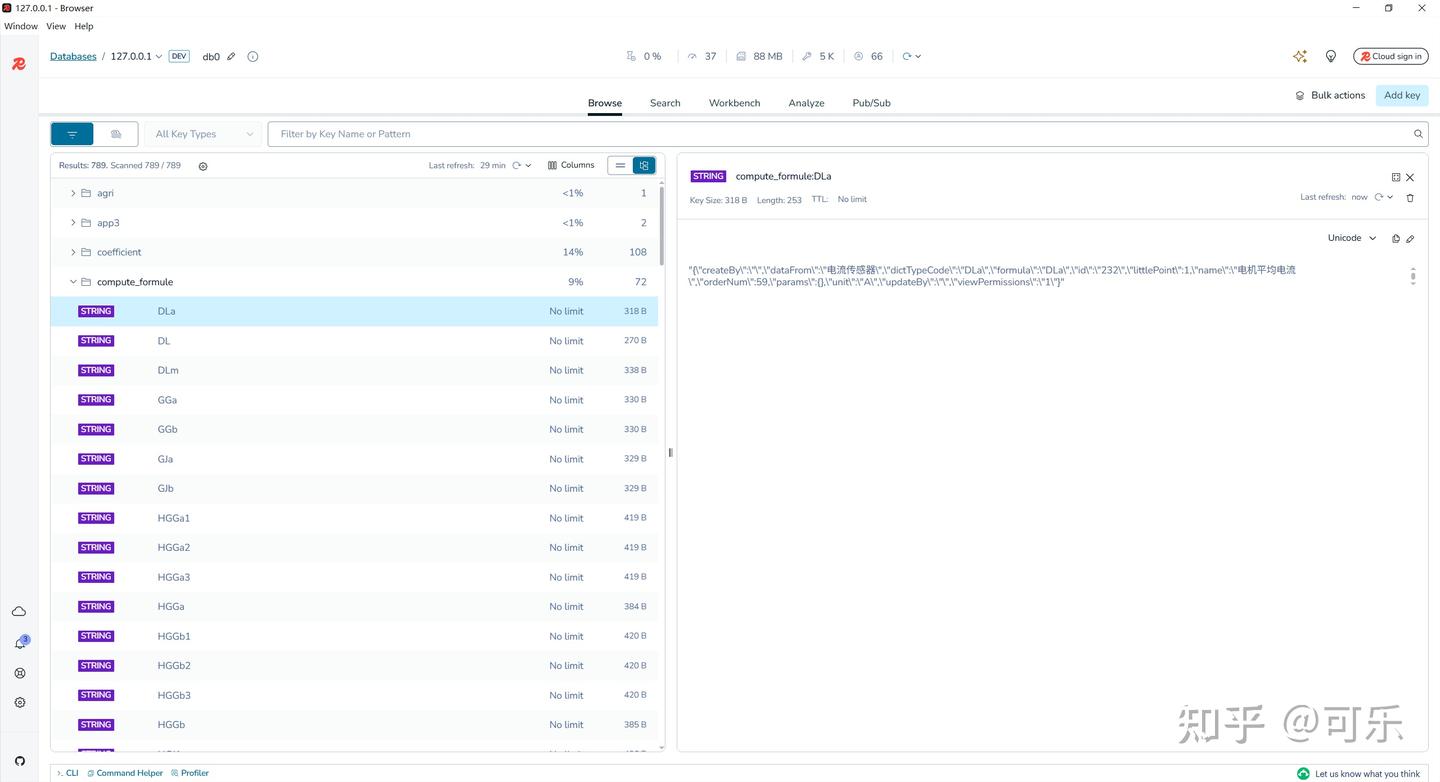
多数情况下按 存储原样 展示。能复制、能改,但缺失语法提示,在「可视化可读」和「实际落盘格式」之间,要靠人为脑补。
RedisViewer 这边
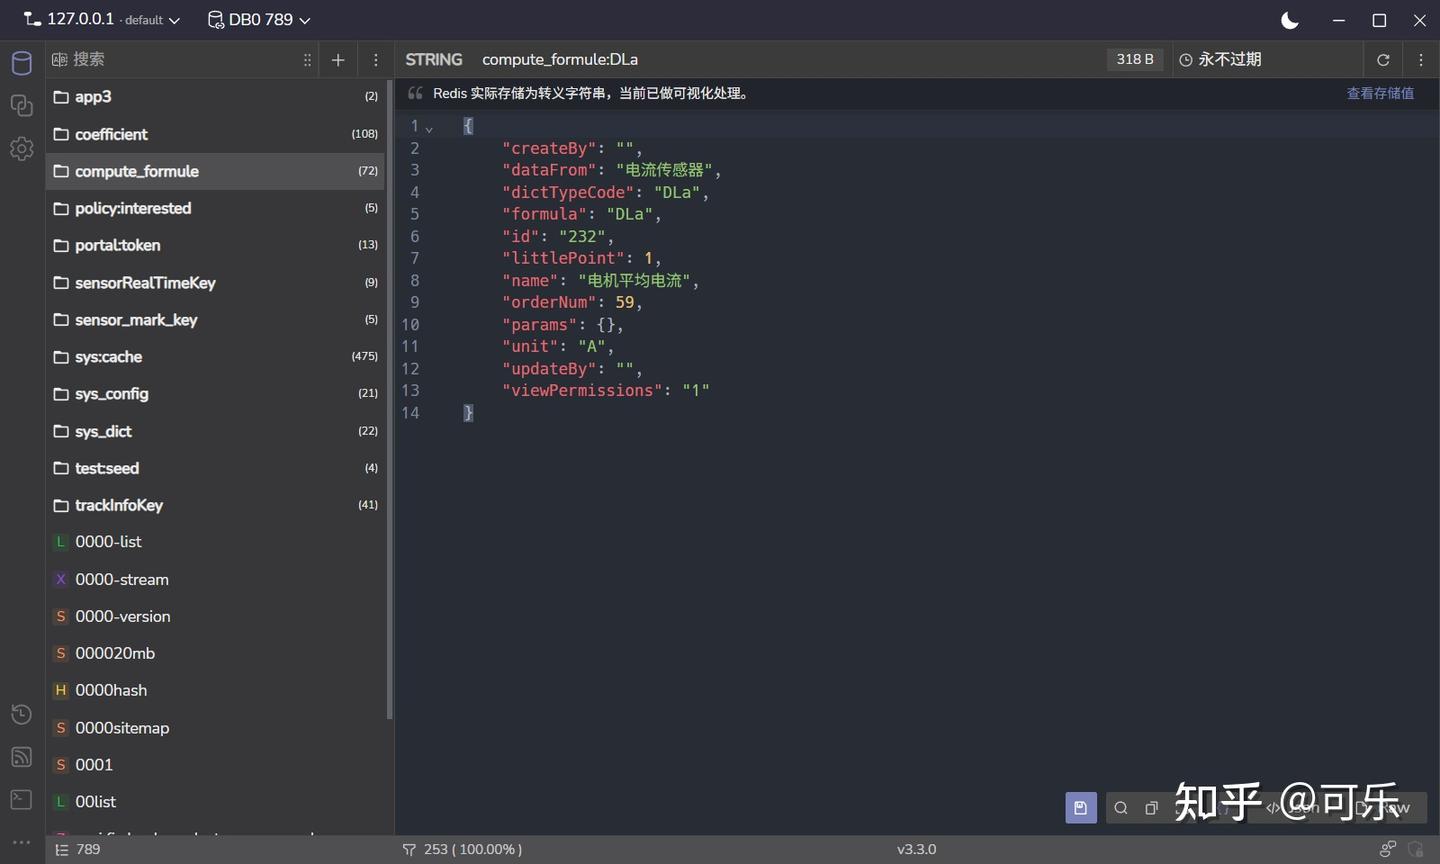 若识别为转义存储,会提示:
Redis 实际存储为转义字符串,当前已做可视化处理。
并支持在两种视图间切换:
| 模式 | 用途 |
|---|---|
| 可视化编辑 | 按「人眼可读」的内容查看 / 修改 |
| 查看存储值 | 对照 Redis 里真正落盘的转义串 |
改完写回时按存储约定处理,减少「界面好看、写回去坏了」的情况。
3. Jackson / Fastjson 多态 JSON:不只是「格式化一下」
Java 项目里,缓存经常是:
{
  "@type": "com.example.UserCache",
  "id": 1,
  "sort": 1L,
  "roles": ["ADMIN"]
}
或 Fastjson 的 @type。这不只是 JSON ,还带 类型元数据;乱改 @class / 字段结构,反序列化就会挂。
RedisInsight 上通常是什么样
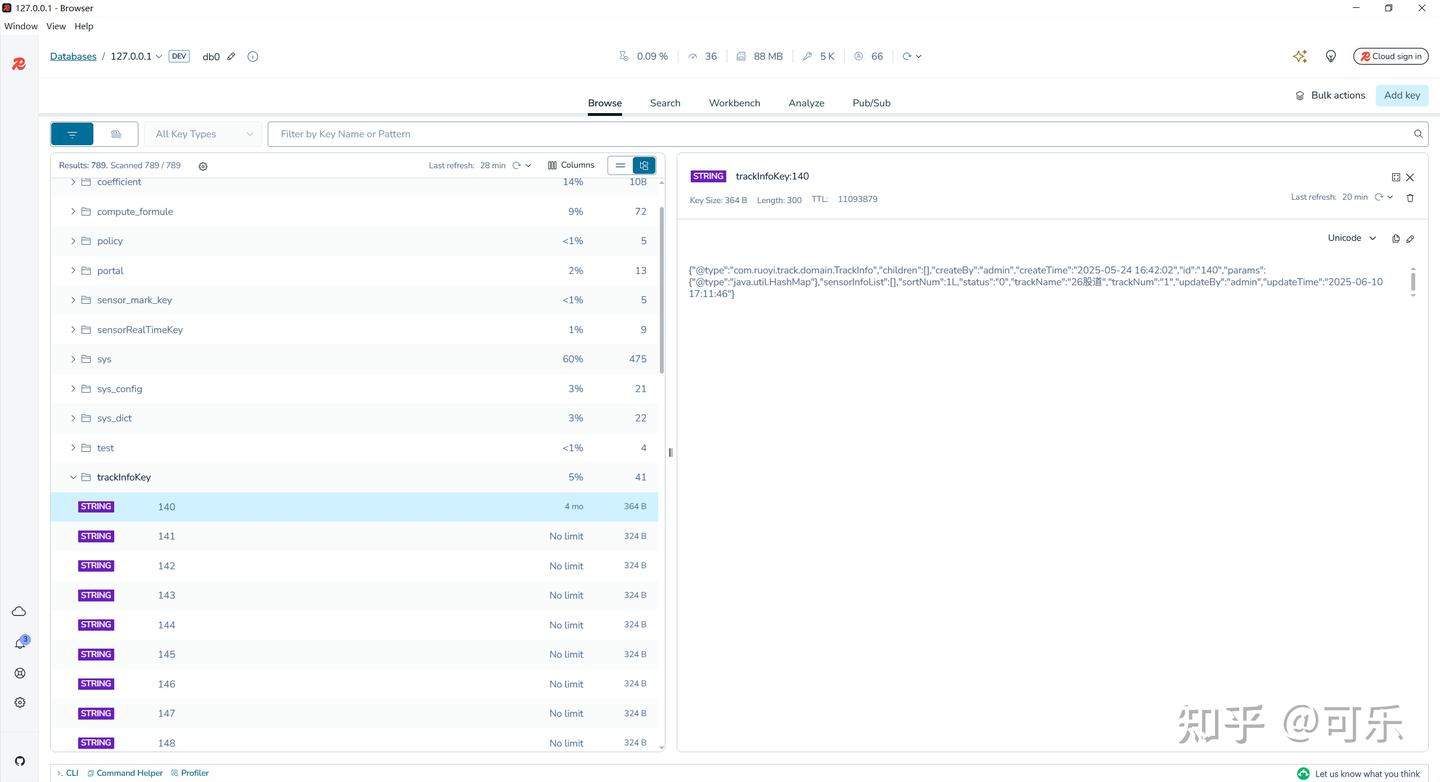
当普通 JSON:高亮、折叠、编辑都行。
但一般不会针对「多态类型字段」给专门提示,改起来和改任意 JSON 一样——对业务反而危险。
RedisViewer 这边
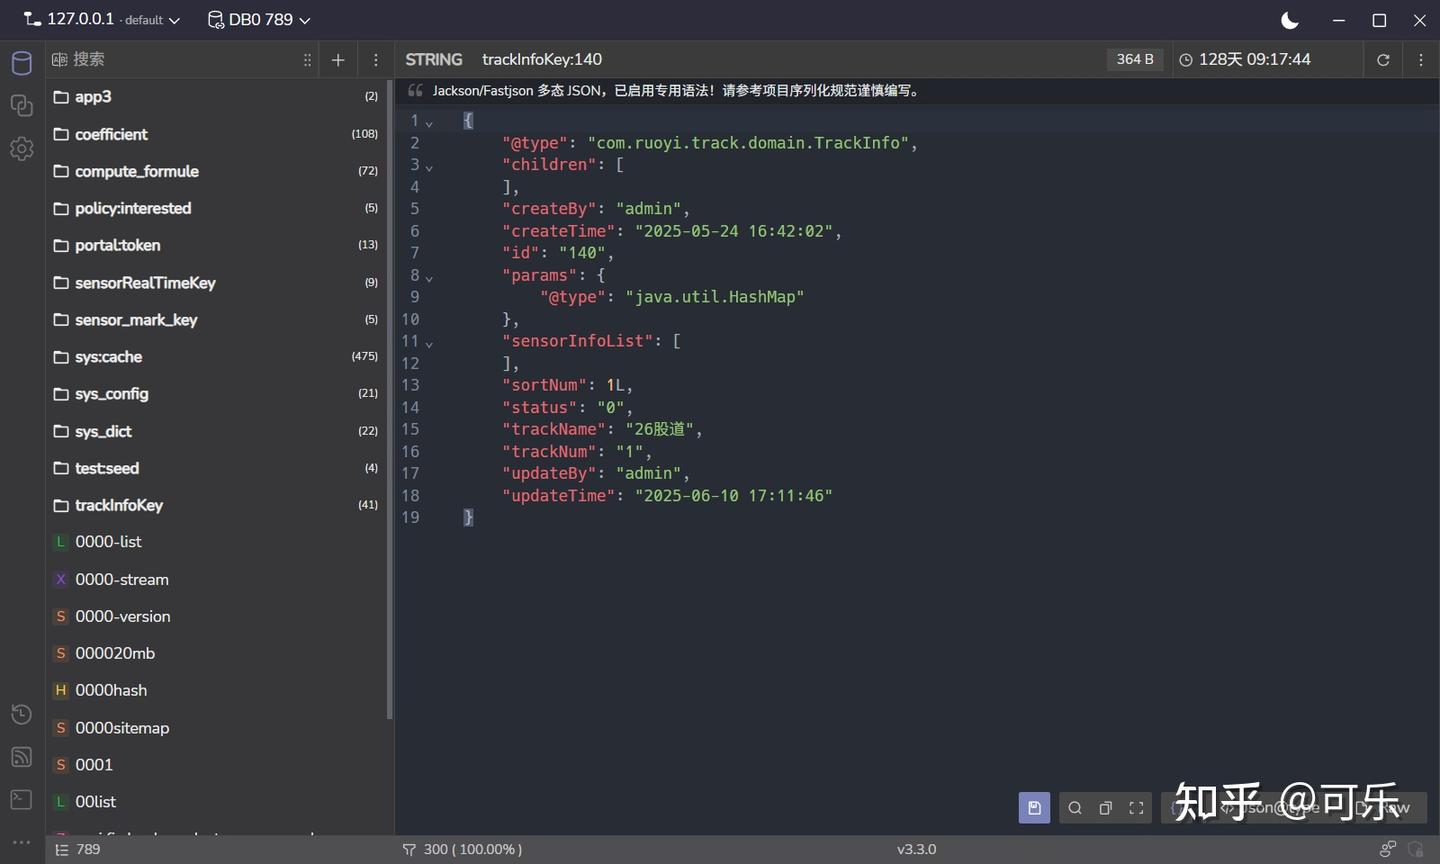
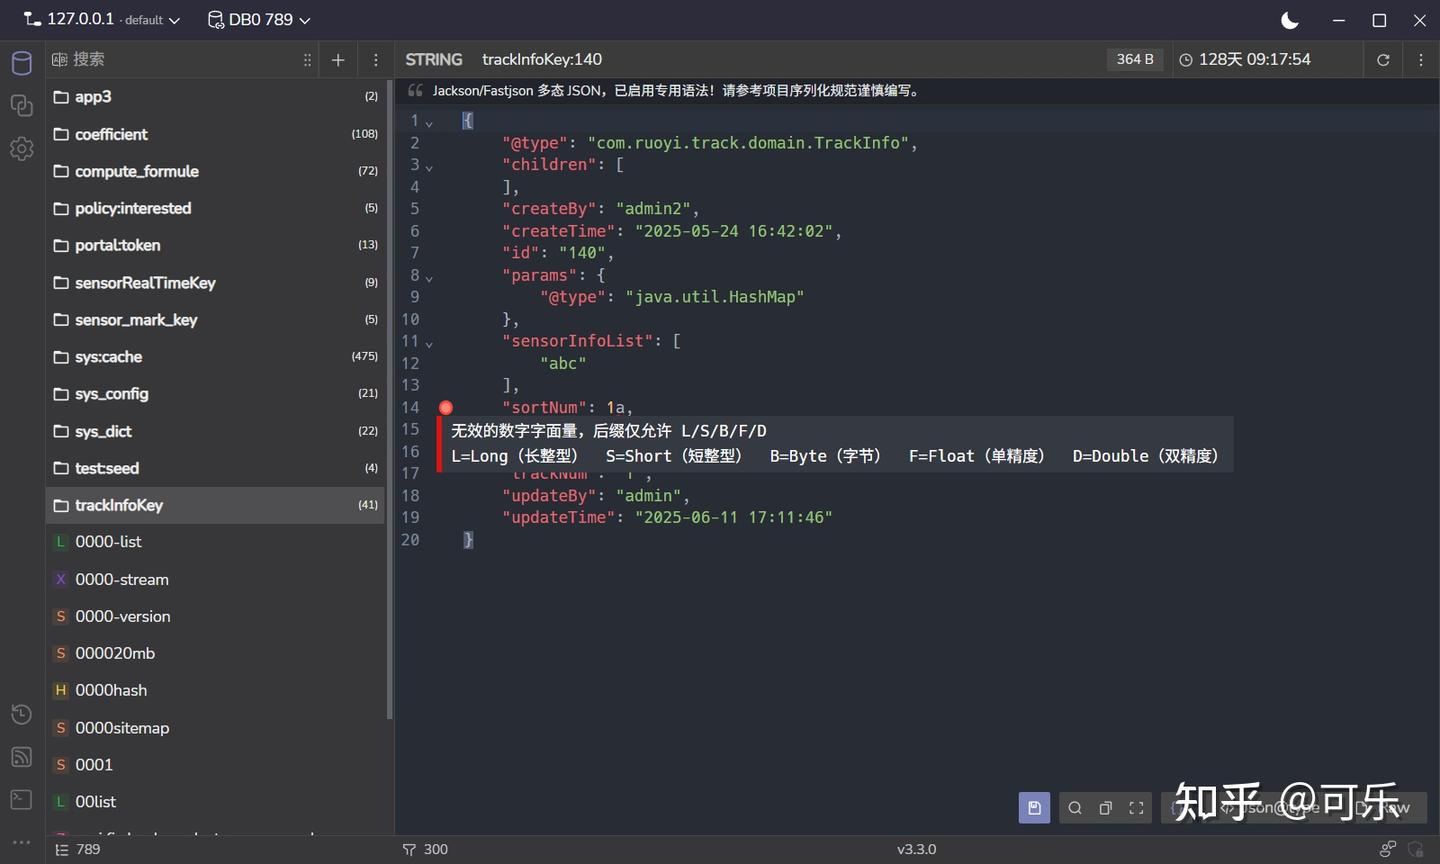
语法可选 Json@type( Jackson / Fastjson 多态 JSON ):
- 按结构查看、编辑
- 顶部有专用提示:按项目序列化规范谨慎编写
- 配合语言服务,减少明显的结构错误
适合「只想改业务字段、尽量别碰类型元数据」的联调场景。
4. 差异视图:提交前确认每一处变更
缓存 Key 改错成本很高:一次 SET 就把错误对象写进共享环境。
很多 GUI 是:编辑区改完 → 点保存 → 直接覆盖。
RedisInsight 上通常是什么样
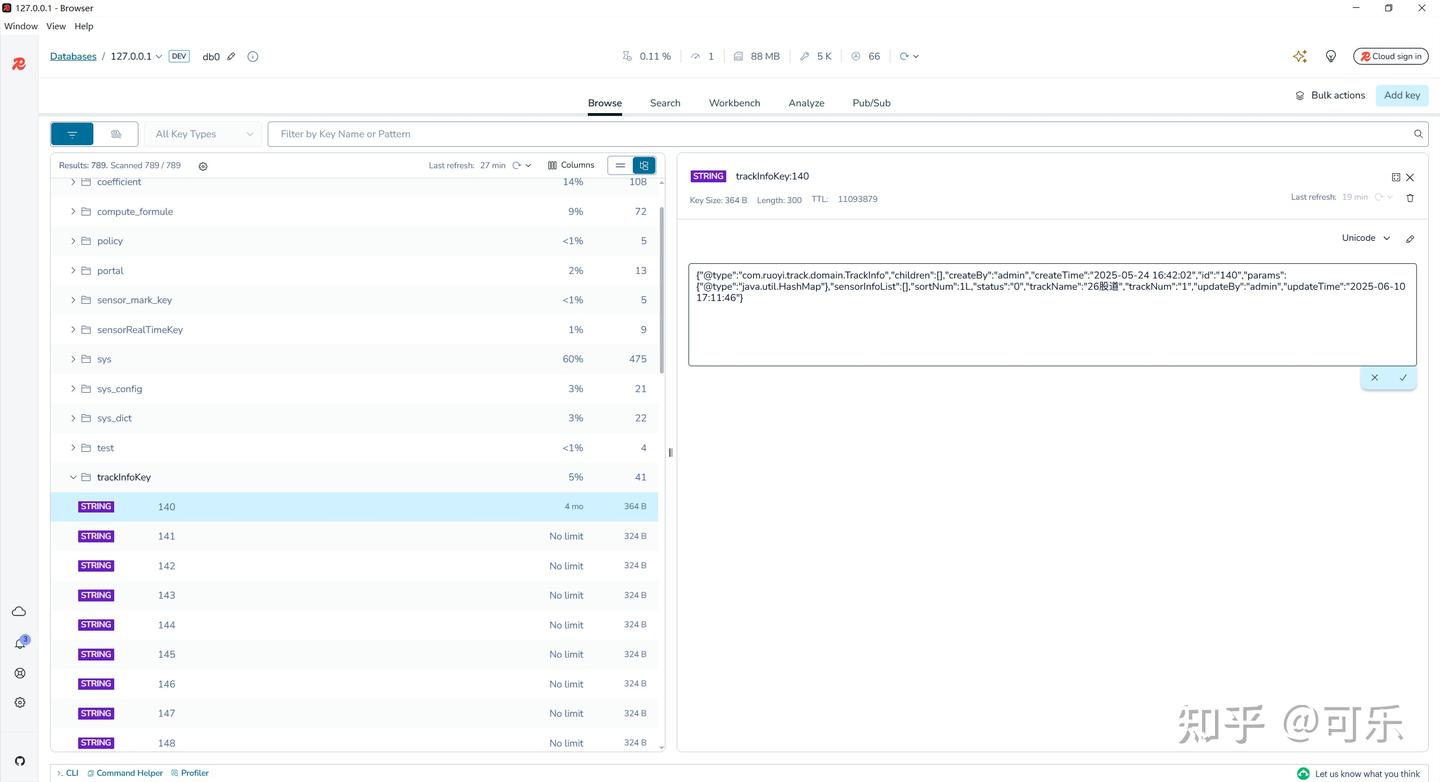
典型流程是直接保存。
有的场景可以自己再 GET 对比,但缺少「保存前、按变更点逐条核对」的内置步骤。
RedisViewer 这边
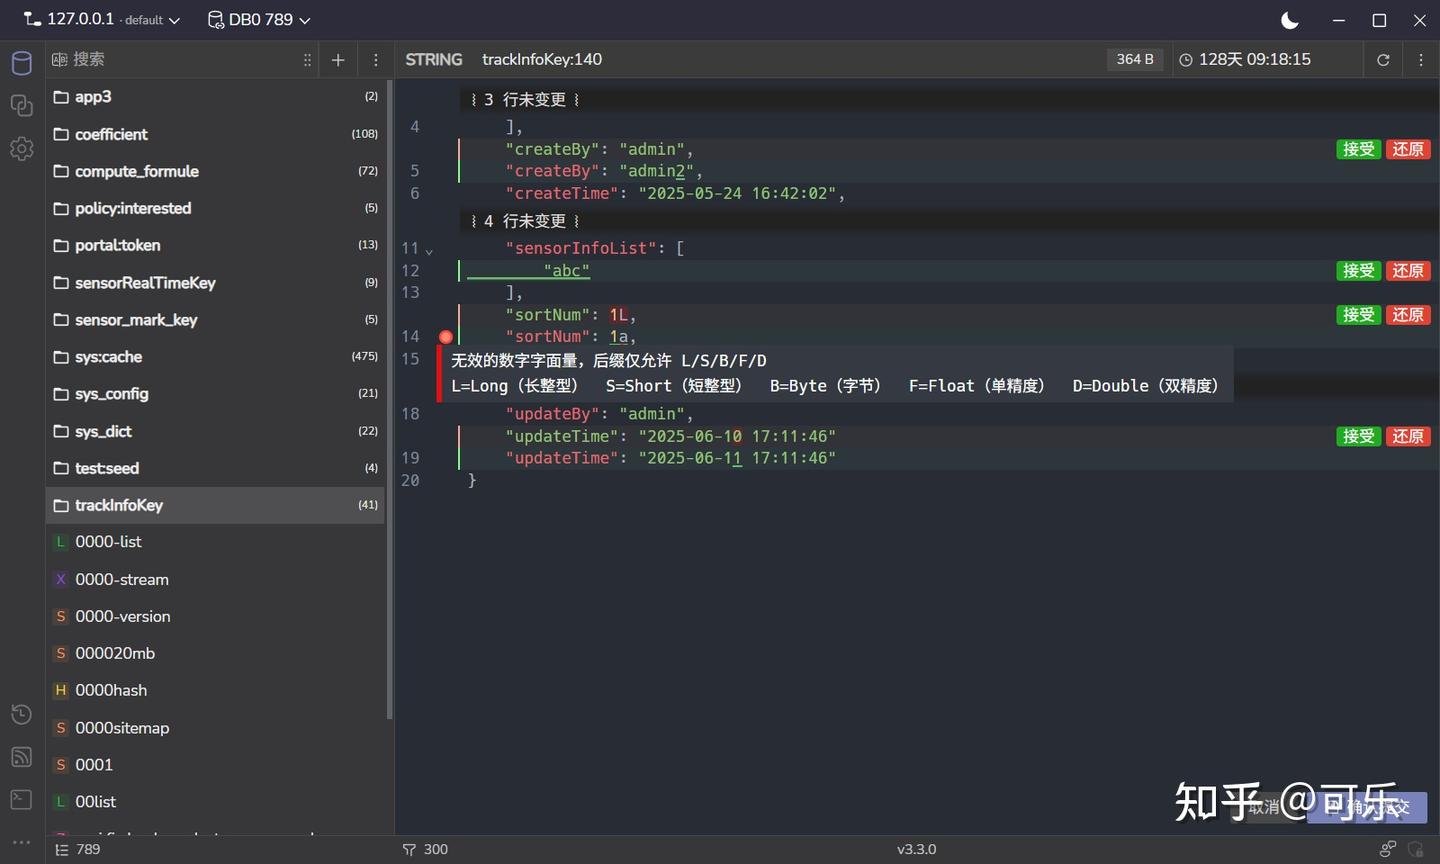
String 等场景保存前可进入 确认保存差异( Diff ):
- 对照修改前 / 修改后
- 对每一处变更可 接受 或 还原
- 确认后再真正写回 Redis
更接近 IDEA 里看 diff 再提交的习惯,适合测试环境改缓存、修脏数据时少踩坑。
对照小结
| 场景 | RedisInsight (常见体验) | RedisViewer |
|---|---|---|
| JDK 序列化 | 乱码 / Hex ,需自备反序列化 | Java 对象树直接看 |
| 转义字符串 | 多按存储原样展示 | 可视化 ↔ 存储值切换 |
| Jackson / Fastjson 多态 JSON | 当普通 JSON | Json@type 专用模式 + 提示 |
| 写回前核对 | 多为直接保存 | Diff:逐处接受 / 还原后再提交 |
RedisInsight 更适合官方生态、Workbench 、模块与通用运维;
RedisViewer 更偏向 Java 研发本地排查缓存:能看懂对象、敢改、改之前能核对。
两者不是互相取代,是场景不同。
其它顺带说明
- 闭源本地客户端,不上传 Redis 的 Key / Value / 凭据,更适合连开发/测试库;生产若强制开源客户端,继续用开源方案即可。
- Windows / macOS / Linux ,免费使用
- 上一篇更偏千万级 Key 与性能排查:做了个支持千万级 Keys 的 Redis 桌面客户端…
- 整体功能介绍:高性能 Redis 桌面客户端 RedisViewer
想听听 Java 同行怎么用的
你们现在排查 Redis 里的 Java 缓存,更常卡在哪一步?
- JDK 序列化完全看不懂
- 转义串改完写不回去
@class/@type不敢动- 改错缓存导致联调翻车
欢迎评论区轻拍
Java 序列化丢进 Redis ,怎么直接看对象
种种原因 Java 服务写进 Redis 的值,经常没法直观阅读,常见几种:
- JDK 原生序列化(
ObjectOutputStream)—— 开头一串¬í/ac ed,后面全是二进制 - 带着转义的 JSON / 文本 —— Redis 里实际存的是
\x、\u、控制字符转义后的串 - Jackson / Fastjson 多态 JSON ——
@type/@class写在 JSON 里,结构对业务很重要 - 改完要写回去 —— 缓存一改错,联调现场就炸
官方工具 RedisInsight 很强:Workbench 、模块支持、官方背书都在。但对上面这几类 Java 研发日常排查,体验往往停在「能看到原始字节 / 原始字符串」
下面按这四个点,对照 RedisInsight 里大概长什么样,以及 RedisViewer 针对性的增强。
1. JDK 序列化:能不能直接看成对象树
业务里很常见:RedisTemplate 默认 JDK 序列化、老项目 setObject、Session / 本地缓存对象直接塞进 Redis 。
RedisInsight 上通常是什么样
打开 Key 后,值区多半是这样的:
- 大量信息缺失:各字段类型、属性从属结构关系等
- 排版简单,不方便阅读,与 Java 对象相去甚远
- 需要充分对照原 Java 对象进行脑补,甚至得自己写一小段 Java / 脚本反序列化,才能确认字段对不对
排查问题或故障时,成本偏高。
RedisViewer 这边
检测到 Java 序列化字节后,自动切换到 Java 查看器,按对象树展开:
- 类名可读(含数组、集合、枚举等常见形态)
- 字段逐级展开 / 折叠
- 日期、装箱类型、UUID 、部分并发原子类等会尽量格式化成可读值
- 需要时仍可回到 Raw / Hex / Base64 看原始内容
目标是:联调时直截了当看清对象长什么样,不写脚本临时解析。
2. 转义字符串:存进去的和「看起来」的不是一回事
有些框架 / 中间层会把内容以 转义形式 写进 Redis (控制字符、\xHH、\uXXXX 等)。用普通 GUI 打开时:
- 要么一整行转义串,眼睛累、不好改
- 要么直接当普通文本,改完写回格式对不上
RedisInsight 上通常是什么样
多数情况下按 存储原样 展示。能复制、能改,但缺失语法提示,在「可视化可读」和「实际落盘格式」之间,要靠人为脑补。
RedisViewer 这边
若识别为转义存储,会提示:
Redis 实际存储为转义字符串,当前已做可视化处理。
并支持在两种视图间切换:
| 模式 | 用途 |
|---|---|
| 可视化编辑 | 按「人眼可读」的内容查看 / 修改 |
| 查看存储值 | 对照 Redis 里真正落盘的转义串 |
改完写回时按存储约定处理,减少「界面好看、写回去坏了」的情况。
3. Jackson / Fastjson 多态 JSON:不只是「格式化一下」
Java 项目里,缓存经常是:
{
  "@type": "com.example.UserCache",
  "id": 1,
  "sort": 1L,
  "roles": ["ADMIN"]
}
或 Fastjson 的 @type。这不只是 JSON ,还带 类型元数据;乱改 @class / 字段结构,反序列化就会挂。
RedisInsight 上通常是什么样
当普通 JSON:高亮、折叠、编辑都行。
但一般不会针对「多态类型字段」给专门提示,改起来和改任意 JSON 一样——对业务反而危险。
RedisViewer 这边
语法可选 Json@type( Jackson / Fastjson 多态 JSON ):
- 按结构查看、编辑
- 顶部有专用提示:按项目序列化规范谨慎编写
- 配合语言服务,减少明显的结构错误
适合「只想改业务字段、尽量别碰类型元数据」的联调场景。
4. 差异视图:提交前确认每一处变更
缓存 Key 改错成本很高:一次 SET 就把错误对象写进共享环境。
很多 GUI 是:编辑区改完 → 点保存 → 直接覆盖。
RedisInsight 上通常是什么样
典型流程是直接保存。
有的场景可以自己再 GET 对比,但缺少「保存前、按变更点逐条核对」的内置步骤。
RedisViewer 这边
String 等场景保存前可进入 确认保存差异( Diff ):
- 对照修改前 / 修改后
- 对每一处变更可 接受 或 还原
- 确认后再真正写回 Redis
更接近 IDEA 里看 diff 再提交的习惯,适合测试环境改缓存、修脏数据时少踩坑。
对照小结
| 场景 | RedisInsight (常见体验) | RedisViewer |
|---|---|---|
| JDK 序列化 | 乱码 / Hex ,需自备反序列化 | Java 对象树直接看 |
| 转义字符串 | 多按存储原样展示 | 可视化 ↔ 存储值切换 |
| Jackson / Fastjson 多态 JSON | 当普通 JSON | Json@type 专用模式 + 提示 |
| 写回前核对 | 多为直接保存 | Diff:逐处接受 / 还原后再提交 |
RedisInsight 更适合官方生态、Workbench 、模块与通用运维;
RedisViewer 更偏向 Java 研发本地排查缓存:能看懂对象、敢改、改之前能核对。
两者不是互相取代,是场景不同。
其它顺带说明
- 闭源本地客户端,不上传 Redis 的 Key / Value / 凭据,更适合连开发/测试库;生产若强制开源客户端,继续用开源方案即可。
- Windows / macOS / Linux ,免费使用
- 上一篇更偏千万级 Key 与性能排查:做了个支持千万级 Keys 的 Redis 桌面客户端…
- 整体功能介绍:高性能 Redis 桌面客户端 RedisViewer
想听听 Java 同行怎么用的
你们现在排查 Redis 里的 Java 缓存,更常卡在哪一步?
- JDK 序列化完全看不懂
- 转义串改完写不回去
@class/@type不敢动- 改错缓存导致联调翻车
欢迎评论区轻拍