70GW“电力缺口”!美国电网、民众和AI巨头,总得有一方“让步”,天量资本开支“无法落地”
商业模式存在“致命”风险!伯恩斯坦:大批Neoclouds将在1-3年内破产
数据中心监管压力加剧!美国多州州长候选人支持暂停建设
OpenAI DevDay 2026
Hi folks,
I’m in sf till Sunday. I wanna meet folks
talk about ai with non-technical adoption
builders doing fun shit
founders working on dev tools/infra
potential LPs (individuals)
go to deli board
Ben’s Bites is brought to you by AWS Marketplace
Most ML teams build data pipelines before they’ve validated their approach. Databricks Data Intelligence Platform skips that step with data federation. Connect directly to Amazon Redshift, experiment on live data, and apply MLOps tooling like CI/CD to your ML lifecycle. See how it comes together.
Headlines
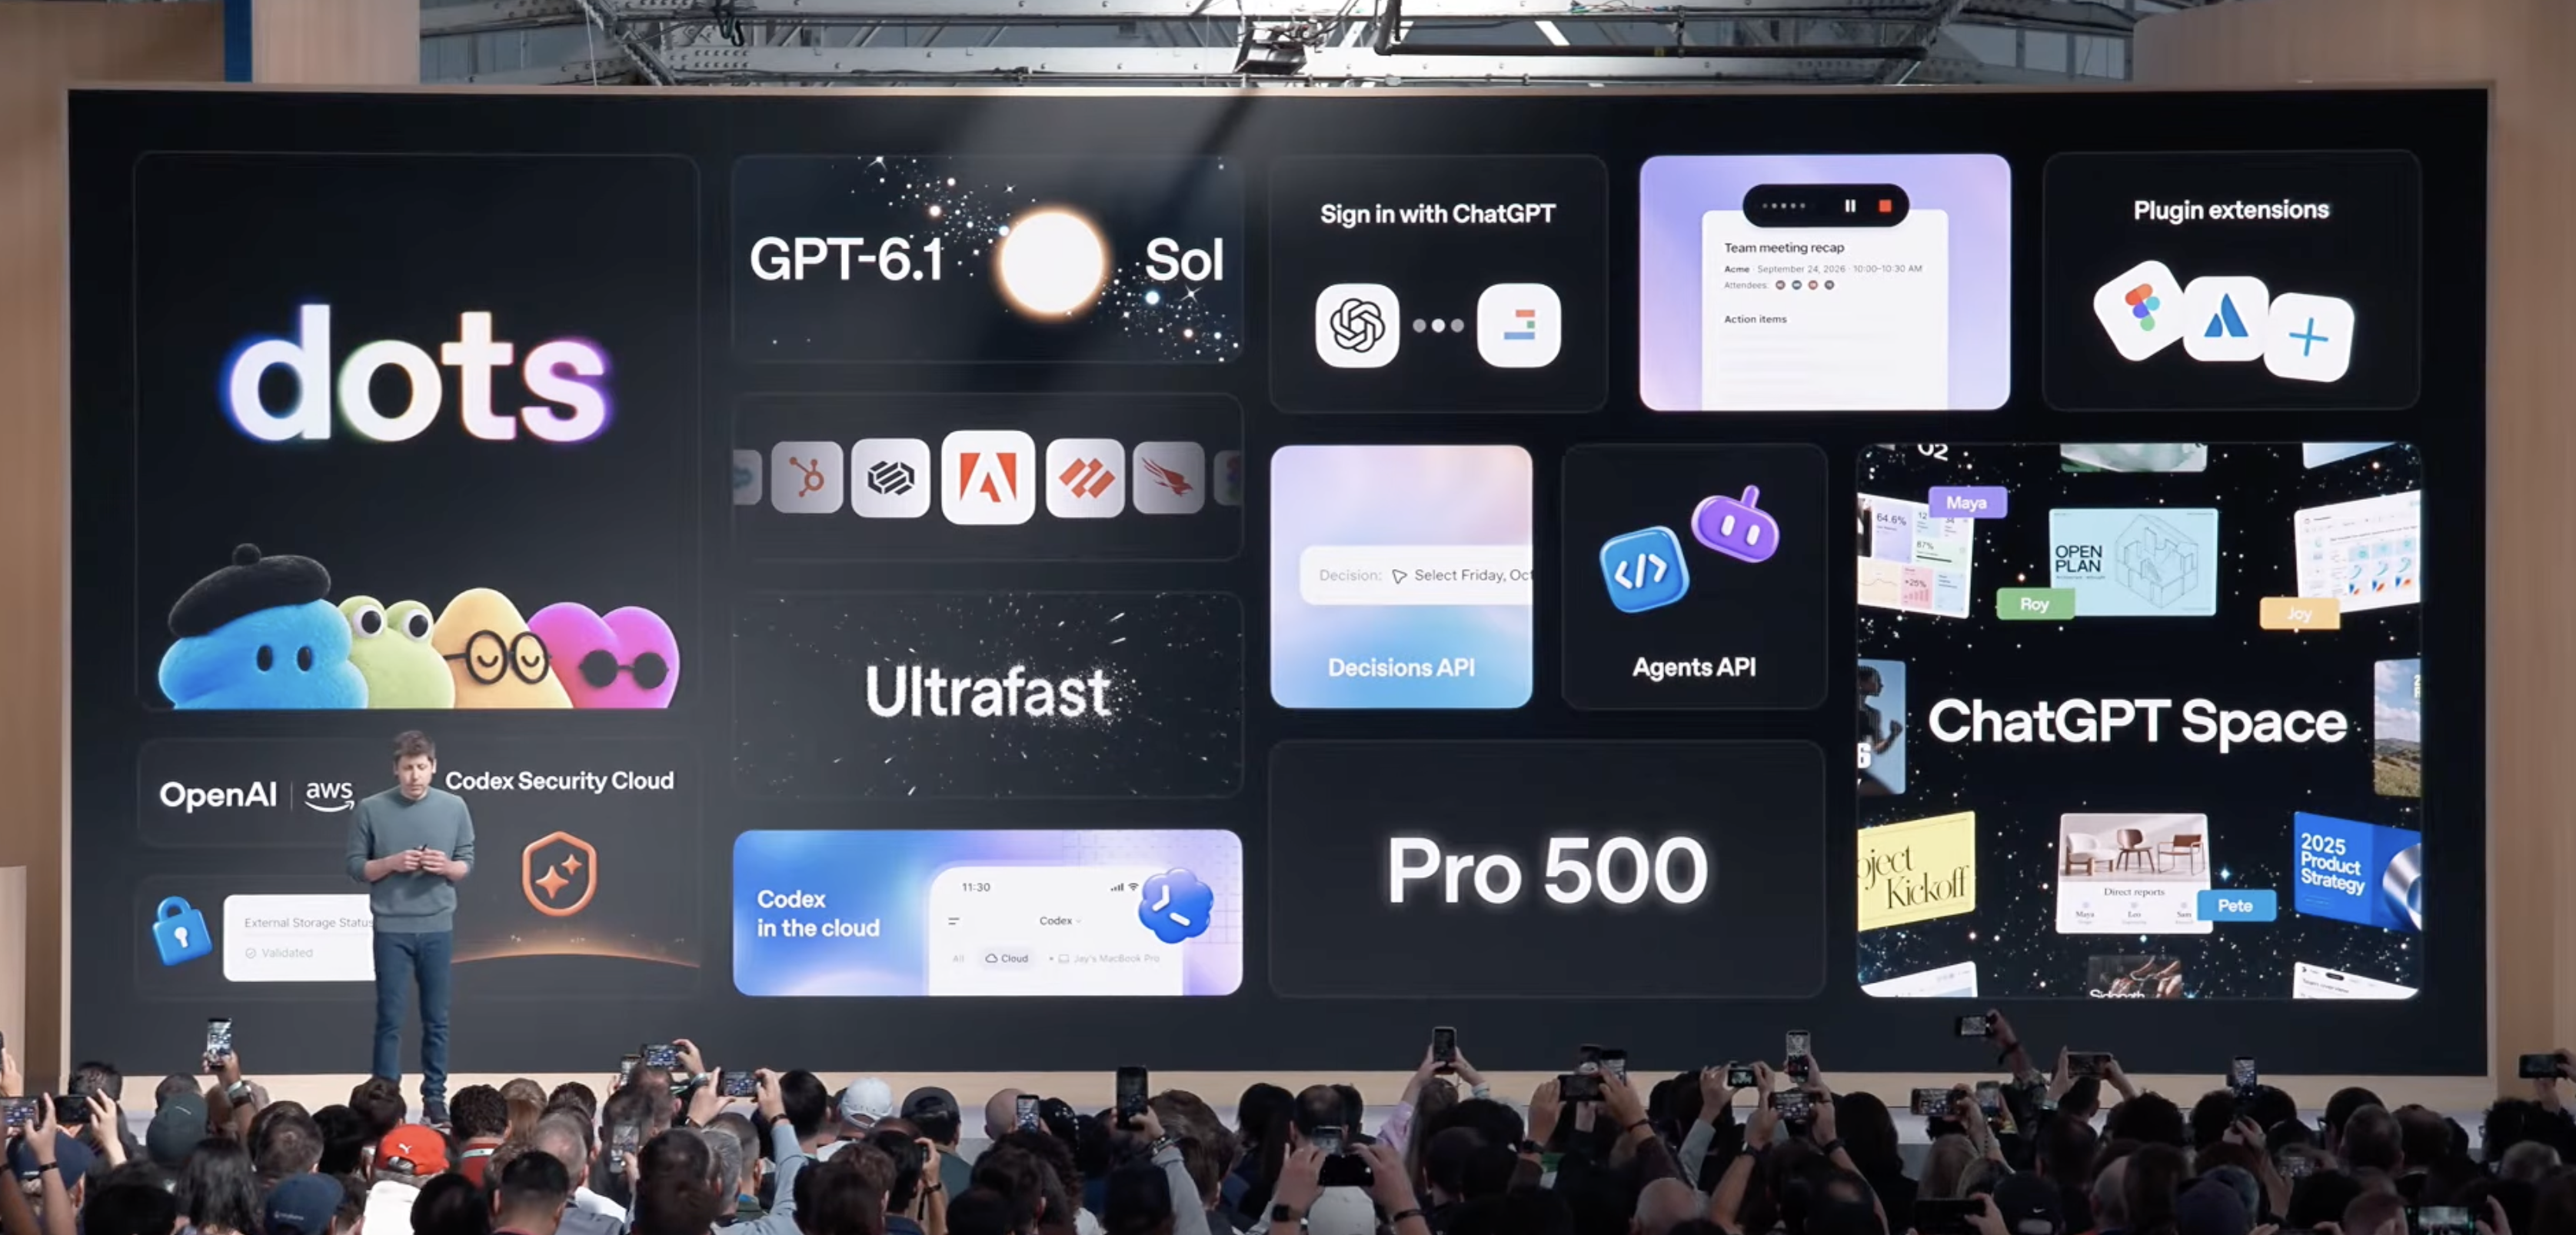
OpenAI DevDay was a blast. Their biggest launch is Dots. Dots is OpenAI’s version of friendly, always-on personal agents.
You can message your Dot or call it like you would a human assistant. You can name it and choose an avatar (can’t do that with a human; they come with those settings preconfigured XD). It can message you back on its own too, i.e. it’s proactive.
Underneath, a Dot is a simple, never-ending chat with GPT-6 Astra. This chat acts like an orchestrator/master chat.
It can take tasks from you, start multiple new chats in Codex/ChatGPT Work to complete them and then report the status to you. Your Dot stays in your ChatGPT sidebar, wherever you use ChatGPT — mobile, web or desktop. It uses its own computer, so you don’t need to keep your desktop ON all the time.
You get one Dot on the Pro plans. It doesn’t draw from your usage limits for now (the chats it spawns for doing work do use your usage, though).
If you remember OpenClaw, the source of magic was multiple markdown files we all created to give our Claws a personality, memory and more. Dots have no clear way to add such files.
Instead, it feels much more tool-dependent. You need it to connect to tools where your life happens to feel the magic of Dots. Your calendar and email are the start. But think Slack, Notion, Jira, your messaging apps and more. Your Dot should take it from there. I think this post from Ethan explains this shift better.
GPT-6.1 Sol - feels like a real upgrade over GPT-5.6 Sol, after GPT-6 Sol felt like a step backwards. More on the model here.
Pro 500 - New plan in ChatGPT, alongside Pro 100 and Pro 200. OpenAI has also balanced the usage limits in each plan as a plain multiplier of the $20 Plus plan. 5x, 10x and 25x for $100, $200 and $500. That means $200 plan users take a hit, but to compensate, they are getting a bunch of one-time credits.
Sign in with ChatGPT - You can officially use your ChatGPT usage in other AI apps now, and developers can apply to add it as an option in their apps to let users pay for AI features.
Plugins - OpenAI’s latest version of “apps inside ChatGPT”. Maybe Dots will drive adoption this time. Early signs look positive. More examples: reminders inside ChatGPT and tldraw’s multiplayer canvas
ChatGPT Space - A Notion-like document workspace inside ChatGPT that you can share with your agents and your team.
Ultrafast - Let GPT-6 Astra work 8x faster, but it uses 6x the normal amount of usage. Only worth it if you have a pile of cash to send to OpenAI.
Google is back on the frontier table. Gemini 4 Argon is their new model — not available to use yet (in classic Google style), but they released its benchmark scores, and it seems better than GPT-6 Astra and Opus 5.5. And it’s cheap, with the promo pricing the same as Sol. I’d rather talk more about this model once it is in our hands.
Muse for Small Business - Meta added Shopify, Stripe, QuickBooks, Klaviyo and more connectors so Muse can help run a small business.
My feed
Decisions API is OpenAI’s answer to Jev, it seems. You define a question and possible answers, and GPT-6 Luna classifies the data. It’s ~10x faster than normal Luna calls, but not as cheap as Jev. OpenRouter has its own version of the decisions api.
Codex cloud now has reusable environments, saving you the setup time every time you run a cloud project.
How Sam Altman uses his dot to run OpenAI, and why his default speed is Ultrafast.
cf - Cloudflare’s new CLI covers its whole API and is built for agents.
Opus 5.5 built someone their own version of Dots/Grok Bot, with ChatGPT sign-in, Claude subscriptions and a cloud computer for every agent.
Claude Code can now build your evals and hill climb on them.
2026 in LLMs (so far) by Simon Willison.
Robinhood plans to let you build agents that can trade on your behalf.
Pi now supports MCP, and makes a case for why after saying it never would.
Reflect Open - open-source notes app where every note is a Markdown file your agents can read.
Get your agents to explain plans, diffs and diagrams visually instead of walls of text with this skill. Just passed 10K stars.
Have some AI experiments that you gave up on? Don’t trash them; instead, extract what’s worth keeping.
One dictated paragraph before a meeting, a full report site by the time it ended.
a16z’s

一天造300万个沙盒,10万张卡自己写系统:2026年国产 RSI 到底有多野?
国产 RSI 的真实水位:没人敢真动模型权重,但所有人都在改 "造 AI 的机器"。 作者丨高允毅
编辑丨岑 峰
RSI,即 AI 造 AI,成为了 2026 年各家模型厂商争相晒的内部成绩单,也是国内一级市场最热的方向之一。只要BP带上 "Self-Training" 的字眼,估值至少多两成。
但真正的 RSI ,不止是 AI 改进 AI ,它还得把经验沉淀下来,让学习方法本身跟着进化。
今年 9 月,上海交大、清华、字节、商汤等机构的 35 位研究者发了篇论文《The Last AI Built by Humans》,给整个行业立了把标尺,它 RSI 分 L1 到 L5 五层,结论令人扎心:
全球前沿大厂的系统大多处于 L1 到 L2 的过渡阶段,L3、L4 在特定垂直领域(如软件工程、科学发现)有零星雏形,而真正的 L5 闭环仅存在于极少数受限的实验室原型中。

如果用这把尺子去丈量九、十月份国内模型厂商晒出的RSI实验成果,包括训练流程、推理系统、 GPU 算子、 Agent 脚手架;但目前没有一家厂商敢去用AI真正改写底层模型权重。也就是说,目前大家距离传说中的“AI 自己发明下一代 AI(L5)”,甚至连门槛都还没摸到。
那么在这场RSI热潮中,国内各大厂与明星创业公司究竟各自卡在了什么生态位?他们分别在让 AI 改进什么、做到哪一步了?以下我们梳理了国内模型厂商最新 RSI 情况。


01
智谱 RSI :跑在 10 万张国产卡上,
能自我优化的推理系统
智谱是国内首个把 RSI 真正跑进生产环境的案例。它的 RSI 第一步没碰模型权重,先落在了最脏最累的底层推理系统上;跑通之后,智谱又把目光放到了 Agent 的 Harness上。前者降本,后者增效,全是实打实的工程活。
先说推理基础设施。一个新模型要真给用户用起来,中间隔着一大堆脏活累活,怎么榨干芯片的算力,怎么把庞大的任务拆分给成千上万张卡同时跑,怎么高效管理对话时产生的海量临时数据等等,这些事过去是 Infra 工程师一行一行调出来的。
智谱这次直接让 GLM-5.3 驱动的“Infra Agent”接管了这一切。9 月 17 日,唐杰在 X 上发了一篇长文《通往递归自我改进》,表示由 GLM-5.3 驱动的 Infra Agent,在 10 万张国产芯片组成的集群上,仅用两周就从零搭起了 GLM-5.3-Flash 的生产级推理服务。

智能驾驶进入物理AI时代?7位行业嘉宾给出最新判断
10月26日,第八届智能驾驶大会暨2026环秀湖物理AI产业发展推介会在苏州相城举行。
上一届,车路云一体化、智能驾驶出海和无人驾驶商业化是讨论重点,而到了今年,大会的讨论边界进一步从智能驾驶向物理AI延伸。
世界模型、强化学习、端侧智能、虚拟仿真、Robotaxi之外,机器人、低空飞行器等不同形态的物理智能开始出现在同一场大会上。这背后,是智能驾驶行业正在面对的一组新问题。
一方面,高阶辅助驾驶已经进入规模化上车阶段,Robotaxi也开始从技术验证走向运营和商业化;另一方面,当AI真正进入汽车、机器人、飞行器等物理设备,如何获得足够的数据、如何训练和验证模型、如何降低开发成本,以及如何保证系统在真实世界中的安全性,正在成为新的技术难题。
当天,包括Momenta、曹操出行、面壁智能等企业,以及高校和科研机构的多位嘉宾,从世界模型、强化学习、端侧大模型、虚拟仿真、车路云和物理AI基础设施等方向给出了自己的判断。
总结这些发言不难发现,智能驾驶正在成为物理AI最早进入现实世界的一块试验场。而从一辆车的自动驾驶,到机器人、低空飞行器以及城市交通系统,不同技术路线正在回答同一个问题:AI如何从数字世界真正进入物理世界,并形成可以规模化运行的产品。
中国工程院院士,清华大学车辆与运载学院教授、智能绿色车辆与交通全国重点实验室主任 李克强
关键词:智能驾驶安全、车路云一体化、单车智能瓶颈
李克强认为,汽车智能化已经进入大规模应用和商业闭环阶段,当前首要问题是智能驾驶系统安全。仅依靠单车自身的传感器和计算能力存在物理边界,高级别自动驾驶需要从单车智能进一步向车云协同、车路云一体化演进。
他将当前自动驾驶产业的瓶颈归纳为三类:一是部分产品定义与国家、国际标准存在偏差;二是高安全、高可靠自动驾驶的关键技术仍待突破;三是行业投入与商业产出仍不匹配。
技术层面,他认为主要存在三个问题:
感知能力仍有边界。如果车辆“看不见、看不远、看不全”,再强的AI决策也无法弥补信息缺失,因此需要通过超视距感知、数字信号上车和协同感知增加信息来源;
AI模型训练数据仍不完整。自动驾驶正在进入多模态和大模型阶段,但数据类型和场景覆盖不足仍可能产生安全问题;
开发效率较低。当前大量系统仍采用“烟囱式”架构,缺乏统一底座,存在开发门槛高、复用率低和验证周期长等问题。
李克强提出,车路云一体化可以提供两类核心能力:一是建立标准化“数据轨道”,向车辆提供广域、多维、实时交通信息;二是形成面向AI大模型的数据服务体系,为模型持续提供高可靠数据。
目前相关方案已经进入产业化验证。包括北京、重庆在内的城市正在开展车企协同开发,应用场景覆盖前方静止障碍物、“鬼探头”、绿波通行等。部分项目已经进入量产阶段,今年已有7家车企推进相关应用,中国一汽也已公布量产导入。
他认为,高级别自动驾驶未来需要解决三个问题:正视安全瓶颈、突破单车智能的物理边界,并通过车路云一体化降低开发成本、提高研发效率。
欧洲科学院院士,清华大学车辆与运载学院教授 曲小波

关键词:物理AI、数字孪生、飞行汽车、需求响应公交
曲小波认为,物理AI正在推动数字孪生从“映射和监视现实世界”,进一步走向“理解、推演并实时控制现实世界”。
传统数字孪生主要完成物理实体到数字实体的映射,但数字端推演往往需要数秒,很难实时控制物理系统。相关国家重点研发项目希望重点解决四个问题:实现具有泛化能力的数字推演、将推演时间压缩到100毫秒以内、建立数字端与物理端互操作机制,以及通过跨尺度、多层次架构降低末端执行误差。
其技术体系分成三个层级:
组件级:提高电机等执行机构的设计效率和执行精度。通过物理AI学习既有电机数据,可以在约10%误差下,将部分单点计算从小时级缩短到毫秒级;
载具级:解决Sim-to-Real Gap、不同机型与动力学适配以及快速验证,应用于自动驾驶、飞行器自主巡航和工程机械自主作业;
系统级:实现多种异构载具之间的协同,包括需求响应公交、低空交通管控、矿山工程机械等。
在飞行汽车方面,团队与奇瑞合作开发了自主巡航复合翼模块化飞行汽车,由机翼、座舱和底盘组成,可以分别组合成自主巡航飞行器和自动驾驶汽车。
工程机械方面,通过世界模型生成候选轨迹并完成轨迹选择,同时优化起铲点和卸料位置,使工程机械能够完成环境建模、铲装、运输和卸料的连续作业。
需求响应公交目前已在湖南株洲职教城常态化运行18个月。当地约有10万名师生,超过50%已经注册使用。与出租车相比,点到点行程时间只相差约2分钟,但平均单次成本约为2元,对比出租车约9.16元。
低空交通方面,则通过构建起降区域全息环境,进行冲突预测、起降排序和资源调度,目前已经在重庆将通航机场改造成飞行汽车起降测试场。
汤元科技CEO 任冬淳

关键词:世界模型、仿真训练、合成数据、虚实闭环
任冬淳介绍了Yootta WorldLoop世界模型,这是一套面向智能驾驶和物理AI的虚实融合闭环训练与评测系统。
整个系统覆盖数据采集、数据生产、算法训练、算法评测、真机验证和数据回流,并由场景生产与编辑、算法训练、仿真评测与真机验证三个平台组成。
其核心技术包括四个模块:
CAD和3D结构数据物理化;
生成式世界模型;
4D数据渲染器;
仿真物理引擎。
其中,3D资产除几何和颜色信息外,还会加入质量、摩擦力、弹力和材质等物理属性,使机器人能够真正与虚拟资产发生交互。
目前相关系统已经覆盖家居、工业、商业零售、智能驾驶行车和泊车五类场景。
在具身智能场景中,可以加载不同机器人的URDF模型,并设置抓取、导航等任务。任冬淳表示,如果通过真机采集1000条抓取数据,每条需要约1分钟,总耗时超过1000分钟;采用GPU并行仿真,可以将同等规模的数据生产和训练缩短到数分钟至十几分钟。
智能驾驶方面,可以利用车端或路端传感器重建真实道路环境,再改变天气、光照、车辆数量等条件,用于行车和泊车算法训练与验证。
目前Yootta已经与尚品宅配开放500套家居场景,每套包含数百至上千个可以与机器人交互的资产。下一阶段计划构建5000个虚实对应场景,发布100万个真实资产、500万小时合成数据,并适配约50款机器人硬件本体。
曹操出行CEO 龚昕

关键词:RoboX、Robotaxi、物理AI Agent、天地空一体化出行
龚昕认为,AI时代出行行业的竞争正在从流量入口转向一体化供给能力。
曹操出行由此提出RoboX战略,希望把网约车、出租车、巴士、低速物流车、货运卡车和eVTOL等不同移动能力,统一封装成可以被AI Agent实时调用的服务。
在这一体系中,用户未来可能不再需要单独打开叫车APP,而是由AI根据日程、位置和个人需求,自动选择并调用相应出行服务。
曹操出行将物理AI在出行领域的商业模式分为四类:
基础出行服务:统一调度Robotaxi、高铁、低空飞行器等交通工具;
超级物理AI Agent:让车辆成为旅游、餐饮、娱乐等现实服务入口;
实时立体数据服务:利用车内外传感器形成实时环境数据,在合规前提下服务企业和城市管理;
分布式算力:进一步利用车辆闲置算力。
支撑RoboX战略的是Robo OS,负责连接线上AI Agent与线下移动载具,并将用户偏好、出行场景、履约结果、位置和路线等真实数据反馈给AI。
目前曹操出行Robotaxi已经覆盖六座城市,车队规模超过200辆;Robo One在长沙、成都部署超过50台,并计划进入苏州。RAS远程中心已经在杭州和苏州落地。
按照规划,到2030年,曹操出行计划在苏州投放数千台Robotaxi和Robo One,实现7×24小时常态化运营。
其发展路径分为三个阶段:2026年跑通Robotaxi和Robo One载人、运货的准入和运营闭环;2027年随着正向研发Robotaxi车型下线开始规模复制;到2030年,将苏州模式向全国及海外市场推广。
爱思人工智能科技有限公司董事长 杨通

关键词:Agnes Harness、物理AI、Test Time Training、硬件协议
杨通认为,AI正在出现三项变化:通用大模型进入更多垂直领域,模型开始通过Skill和训练反馈实现自我进化,以及大模型开始直接连接物理设备。
基于这一趋势,爱诗人工智能开发了Agnes Harness,希望降低通用模型向垂直智能体和物理AI应用迁移的成本。
Agnes Harness采用前后端解耦设计,将模型能力与MaaS、记忆、沙箱、搜索与工具、上下文管理、团队协作等能力封装起来,再通过Plugin和Skill机制适配不同应用。
在物理AI层面,其核心能力之一是MHS,即通过标准硬件协议,让大模型能够用自然语言连接显微镜、医疗设备、摄像头、无人机等可编程设备。
目前已经进行小车与机器狗协同实验,两台设备依靠摄像头感知环境,再由大语言模型直接参与决策,不使用传统遥控,也不需要完整预设动作流程。
另一个重点是ISI,主要包括两部分:
将模型运行过程中的能力持续沉淀为Skill;
通过TTT(Test Time Training)让模型在实际运行过程中继续更新。
杨通表示,传统模型数据采集、训练和推理由不同团队完成,模型上线以后往往长期不变;TTT希望把数据采集、执行反馈和模型更新连接起来,使模型能够针对具体环境持续适应。
目前相关实验使用约0.9B参数模型进行验证,部分模型约每半小时更新一次。在游戏测试中,持续积累Skill后,部分任务胜率从约3%提升到90%,三对三场景从0提升到约60%。
目前爱诗人工智能模型月调用量约65万亿Token,月图片生成量约5000万张,视频生成量约1.7亿秒。Agnes相关系统已经被用于芯片设计、算子优化、无人机集群、蛋白质合成等场景。
Momenta副总裁 顾功尧

关键词:高阶辅助驾驶、世界模型、强化学习
顾功尧认为,中国高阶辅助驾驶已经进入快速上量阶段,城区NOA方案开始进入10万元及以下车型,全球市场则整体晚于中国数年。
Momenta的业务模式可以概括为“一飞轮、两条腿”:一条是量产辅助驾驶,另一条是L4规模化无人驾驶。量产车型持续产生真实道路数据,再反哺Robotaxi等L4产品。
目前,搭载Momenta辅助驾驶系统的乘用车已经超过130万辆,累计定点超过240个,交付120多款车型,累计真实行驶里程约200亿公里。
Momenta将物理AI理解为“世界模型+强化学习”。
其R7世界模型主要分为三个阶段:
预训练:利用上百亿公里真实道路数据,让世界模型学习物理规律、交通行为和道路常识;
仿真推演:模拟自车和其他交通参与者的行为变化;
强化学习:在世界模型构建的仿真环境中进一步训练车端驾驶模型。
Momenta目前使用统一模型架构支撑L2++到L4产品,量产辅助驾驶、Robotaxi等产品共用同一条模型和数据主线,只根据法规和安全要求设置不同冗余。
R7已经应用于多款量产车。例如复杂山路中,系统需要同时处理骑行者、隔离带和对向车辆,寻找短暂的安全超车窗口;在夜间城区绕过违停车辆时,还需要提前识别远处隔离墩,并规划重新回到原车道的轨迹。
Momenta正在预研下一代R9世界基础模型。R7参数规模约10亿级,R9计划提升到约千亿级,同时车端芯片算力也从百TOPS级向千TOPS级演进。
R9希望进一步理解更加细微的物理变化,例如不仅识别山体落石,还能够推演落石后续运动是否符合自由落体规律。
面壁智能联合创始人兼首席科学家 刘知远

关键词:密度法则、端侧智能、全模态感知、物理AI
刘知远认为,大模型过去八年的核心变化并不只是参数规模持续扩大,而是形成了一套可以不断吸收不同类型数据的通用技术路线。
随着模型继续扩大,数据和算力正在成为新的约束。
在数据侧,从2024年前后开始,大规模强化学习推动模型由模仿学习向探索式学习发展,使模型可以主动探索并生成新的训练数据。
而在算力侧,如果仍然只依靠扩大参数规模提升能力,计算需求最终难以持续。因此,大模型还需要提高“智能密度”,即使用更少参数和算力达到相同智能水平。
面壁智能由此提出“密度法则”。
根据其观察,全球开源大模型的智能密度大约每100天提升一倍,即大约每100天就可以用一半参数和一半计算量,实现此前相近的智能能力。
刘知远认为,这类似于半导体行业的摩尔定律。未来模型一方面会不断变小,手机、汽车、机器人等终端算力另一方面会继续提高,两条趋势最终交汇,使过去只能运行在服务器上的大模型逐步进入终端。
他将未来AI分为三种形态:超级智能、云侧智能和端侧智能,其中端侧智能将成为物理AI的重要载体。
人工智能进入物理世界还存在三个趋势:
高智能密度:降低模型运行所需的参数和算力;
全模态感知:通过视觉、声音和其他传感器理解现实世界;
自主智能体:在开放环境中持续决策、学习和行动。
面壁智能已经将端侧模型应用到手机、汽车座舱、卫星和机器人等场景,并与华为、三星等企业开展合作。
按照密度法则推算,如果智能密度继续维持约100天翻倍的速度,不到两年时间,同等能力所需的参数量和算力可能下降两个数量级,使原本万亿级模型的部分能力压缩到百亿级,并部署到终端设备。
刘知远认为,未来大模型将持续进入手机、PC、汽车、机器人、可穿戴设备和IoT等终端,端侧智能将成为AI进入物理世界的重要路径。雷峰网雷峰网
从“懂回答”到“能执行”:Zoho如何让AI走进企业业务
10月20日,在以“助力中国企业全球化成长”为主题的Zoho北京媒体沟通会上, Zoho不仅向外界展示了其最新的企业级AI全景战略,更试图回答一个当前行业的普遍痛点:当AI大模型喧嚣了两年之后,为什么大多数企业在业务中依然觉得AI“用不起来”?
Zoho全球副总裁Mathivanan一针见血地点出了症结所在:“太短的决策周期,太多的备选工具,从一开始就造成了太多的数据孤岛。”当企业盲目堆叠各种带有AI标签的软件,不仅没有打破原有的信息孤岛,反而催生了“AI孤岛”。
Zoho中国COO夏海峰在随后的主题演讲中直言不讳:“如果AI只能回答问题、提供信息,却无法参与实际业务流程,它对商业的价值就微乎其微。”
这也揭示了企业AI应用面临的一道关键门槛:能够回答问题,不等于能够完成任务。AI要真正参与业务,不仅需要理解用户的需求,还需要获取相关数据、调用业务系统,并在权限和流程约束下完成具体操作。
为了跨过这道从“懂回答”到“能执行”的鸿沟,Zoho在此次会上系统展露了其沉淀多年的AI全景三层架构:底层给数据,中间层做连接,上层管执行。
跨越分水岭:从“会说”的助手,到“能干”的数字员工
在Zoho的AI全景图中,最上层是直接触达业务的核心。Zoho认为,真正的AI分水岭在于它能不能接下任务,并跑通多步骤流程。
首先是原生嵌入业务场景的对话式AI助手AskZia。它并非独立的外挂工具,而是深植于CRM、财务、客服等系统内。用户可以通过自然语言获取信息、分析业务数据,并在相应功能支持下完成内容起草与润色等工作。
但“会说”只是第一步,“能干”才是企业真正的刚需。Zoho推出了预置智能体Zia Agents,销售教练、SDR机器人等上百个开箱即用的角色,专门处理那些有规律、可复用、吃经验的工作。
而对于规则极其复杂、个性化极强的场景,Zoho提供了Agent Studio低代码平台。例如,一家汽车零部件客户就利用该平台,开发了专属于自身的成本预测智能体,有效应对国际贸易中由关税、运输等因素造成的材料成本波动。这种让非技术人员像搭积木一样定制专属AI的能力,正是Zoho区别于标准化SaaS产品的差异化护城河。
从Ask Zia到Zia Agents,再到Agent Studio,三者分别对应信息获取与处理、特定任务执行,以及面向个性化流程的智能体构建。它们的区别不只在于AI能力的强弱,更在于AI参与业务的方式发生了变化:从辅助员工完成工作,逐步延伸到承担特定任务。
连接与底层:不卷参数,只做适合业务的“原生智能”
如果说AI执行层是冰山露出水面的部分,那么数据和连接则是水面之下的庞大基座。在中间层,Zoho通过MCP(模型上下文协议)打通了内外生态。
夏海峰在会上描绘了这样一个场景:用户在WorkBuddy、豆包工作、千问办公等支持MCP的客户端中,配置自定义连接器,接入Zoho MCP,即可在外部直接对话操作Zoho CRM,实现数据的自动更新。Zoho MCP目前兼容Claude、ChatGPT等主流大模型与智能体,并提供300余款第三方服务的集成清单。通过标准化协议,Zoho不仅让自家的业务能力能够被各类外部智能体调用,更确保了敏感数据在离开系统前就被遮蔽与鉴权,实现了真正的开放与安全并行。
MCP的意义,在于为AI工具连接外部应用提供标准化的交互方式。对企业来说,这意味着AI的使用场景不必局限于单个软件内部,也可以向跨应用的工作流程延伸。
除了系统连接,模型本身也需要适配不同的业务任务。
在算力与模型动辄追求百亿甚至上万亿参数的今天,Zoho在底层选择了一条极为务实的路径。Mathivanan表示,Zoho的投入不跟风竞争对手的烧钱规模,而是按客户真实需求决定。相较于消耗巨大资源的通用大模型,Zoho更倾向于自研部署在自有数据中心的中小模型。“例如自动回复邮件、图片内容总结或者情感分析等场景,只需要部署适合的模型即可,这不仅提高了业务精准度,也极大降低了推理成本。”
这种对业务边界和成本的极致把控,也体现在AI编程的应用上。面对AI写代码是否会取代传统软件的疑问,夏海峰用“冰山理论”给出了回答:AI编程只是冰山上露出水面的一角,源码托管、权限设计、安全运维、底层数据治理这些看不见的部分,才是真正下功夫的地方。Zoho将AI编程能力赋能给用户,是为了让他们在现有的、稳固的业务底座上做扩展,而非凭空去造一个悬在半空的应用。
长期主义的底气:AI不是增项收费,而是软件的基础设施
在商业模型上,Zoho的选择同样“反直觉”。当部分厂商试图将AI能力作为独立套餐向客户收取高昂费用时,Zoho在会上主张,将AI融入产品体系,而不是简单地将其视为一项独立的增值功能,目前并不会向客户额外收AI费用。
这一决定的背后,是Zoho坚持了30年不融资、不上市的长期主义底气,对于企业级AI而言,底层投入的意义不仅在于提供算力,还在于支持产品运行、数据管理和不同业务应用之间的协同。
数据安全则是另一项不能绕开的基础要求。Mathivanan将其定义为“过渡期的底线”:不管是用企业自带的API Key接入外部模型,还是使用Zoho自研的模型,Zoho都承诺不拿客户数据训练通用模型,所有的技术探索最终都指向一个目标——保护客户的数据安全与隐私。
因此,企业部署AI不能只关注模型能力,还需要结合实际应用场景评估数据处理方式、权限配置和外部服务的接入边界。对软件厂商而言,AI能力的开放程度与数据保护机制并不是相互独立的两件事:只有明确访问范围和执行权限,企业才更有条件将AI用于真实业务。
正如夏海峰在演讲最后所总结:“随着智能体具备调用API和自主执行任务的能力,企业软件不再只是供人操作的功能工具,同时成为承载智能体开展业务的底座。企业上AI,不是选一个更聪明的模型,而是决定把哪些环节交给机器,以及为此准备好什么样的底座。Zoho要做的是把"AI + 自主执行"真正落地到企业全场景,而不是讲故事。“
从AI助手到智能体,从模型选择到系统连接,Zoho正在将AI能力融入企业现有的产品与业务流程,让AI从辅助信息处理,逐步走向具体任务的执行。
AI正在改变企业软件的使用方式,也在推动SaaS重新思考自身的价值。未来SaaS的竞争,不仅在于提供多少功能,还在于能否让AI真正参与业务,并将技术能力转化为实际的业务价值。
雷峰网

2026 全球 AI 新云 NeoCloud:考验基本功的时候到了
10月19日,一张全球AI新云(NeoCloud)产业图谱引发行业关注。
CoreWeave、Nebius以GPU云服务为核心;Lambda、Together AI与九章云极 DataCanvas则在算力供给之上,跨入“训练・推理・Token工厂”交叉赛道;AI 工程与AIDC运营,则作为底层底座贯穿整条产业链。在这场全球竞争中,九章云极是为数不多跻身第一梯队的中国厂商。
2026全球顶级AI新云NeoCloud图谱
这张图谱提供了观察行业的窗口:全球NeoCloud服务商正在告别单一算力售卖模式,走向商业模式分化、能力边界持续延伸的专业化赛道。
资本对头部标的的评估标尺也随之迭代,算力规模、硬件跑分等浅层指标逐步失效,行业核心评判标准收敛至四项:总体拥有成本(TCO)、训推交付稳定性、Token服务效率、AI基础设施工程成熟度。四项指标共同锚定技术底盘、履约能力、客户价值与长期经营质量,把短期算力红利沉淀为可复购、可持续的服务价值。
01
全球AI新云巨头分野
2026年,全球NeoCloud分层格局已经明朗。
Gartner高级总监分析师Enrique Castera提出,具备长期投资价值的新云厂商,除差异化技术能力之外,还需要稳定的客户结构、健康的财务模型与标准化企业级交付能力。
行业退去“有卡就能盈利”的幻想,集群供给、模型服务能力、工程运维水平、融资成本,共同划定企业的增长上限。
从业务路径划分,当前NeoCloud演化出三条并非互斥的赛道。
第一类,是以GPUaaS为核心,主打算力供给效率,代表厂商为 CoreWeave、Nebius。竞争围绕大规模GPU集群、AI原生云底座建设与算力交付效率展开,叠加融资成本决定单位算力盈利水平,客户以大模型研发企业与大型集团为主。
第二类为GPUaaS叠加MaaS,从算力向上延伸至模型服务,Lambda、Together AI、Crusoe、GroqCloud、九章云极DataCanvas均布局于此。其核心增量不是外挂一层模型API,而是打通算力与模型运行链路:训练团队需要弹性大规模集群,应用开发者需要低抖动、高吞吐的推理接口,政企客户看重合规可控、成本可预测的完整服务。
第三类将算力、模型服务统一纳入AI Engineering体系,依托优化物理编排与AIDC 运营为底座,逐层对外开放。这条路线在中国及算力主权市场都具备特殊现实意义。随着模型与集群规模扩张,算力能否释放理论性能,高度取决于软硬件协同。客户采购算力之后,环境适配、模型调优、运维排障会持续消耗研发资源;集群越大,网络、存储、散热、故障自愈越容易成为瓶颈。AI Engineering负责调度适配、训推优化与全链路运维;AIDC运营保障供电、网络、容灾稳定——硬件理论性能,只有在工程与基础设施协同之下,才能转化为稳定的生产算力。
九章云极DataCanvas是国内率先打通GPUaaS、MaaS、AI Engineering的新云厂商,同步参与多条赛道竞争。平台基于异构算力调度、训推编排、自动化运维搭建一体化底座,可帮助客户将TCO降低73.8%。
赛道边界持续消融,伴随硬件迭代与应用落地,AI新云正在发生训练、推理、Token 三重技术裂变与商业模式变化。竞争落脚点,最终是算力资源向标准化、可付费服务的转化能力。
02
国内市场:评估标尺回归业务本质
中国AI新云已进入训练与推理双轮驱动的增长周期。
IDC数据显示,2025年国内智算云基础设施(AI IaaS)市场规模486.7亿元,同比增长128%;同年公有云公有云MaaS模型调用量达到1944万亿Tokens,增幅约16倍,对应营收30.7亿元。IDC预测,2026全年Token消耗量将达到约4万万亿Tokens,公有云MaaS营收有望攀升至186亿元。

中国公有云MaaS市场进入高速增长期,Token经济从概念走向规模化实践
AI IaaS代表底层基建需求,MaaS代表模型商业化落地规模,二者不能简单加和,但共同印证增长同时发生在算力底座和模型服务两端。赛道热度持续吸引资本入场,2026年,花旗研究看好AI新云平台从算力供应商向完整AI平台演进,支撑逻辑包括GPU供需格局、企业AI应用渗透、底层软件栈升级。但资本市场已经告别无差别看多,融资成本、交付履约、细分增速、技术储备,都列为核心考察项。
落到厂商层面,具备可比性的评估指标回归业务本源:
总体拥有成本(TCO),衡量客户综合投入;训练与推理效率决定算力产出价值;Token 服务能力决定模型服务的经济性;AI Engineering工程能力决定AI落地效率。
这套指标串联技术与商业:对厂商,它决定红利能否转化为收入、现金流与关键场景;对客户,它决定采购的算力能否变成可用的AI能力。
03
九章智算云率先跑通全栈路径
在全球NeoCloud第一梯队图谱中,九章云极DataCanvas是少数具备完整全栈能力的中国厂商,在TCO、训练、推理、Token生产四项核心指标上达到国际领先水平,并被Forrester列为亚太地区普惠算力利用率的领先者之一。

2026全球AI新云NeoCloud细分业务能力可比性评估,九章云极位于第一梯队
区别于单纯供给算力资源,九章智算云依托“训推一致+AI工厂”闭环体系,打通异构算力调度、训推协同与底层基础设施运营,走出适配复杂硬件生态的差异化路线。
训练侧,九章智算云以长期有效算力利用率为核心,而非单纯比拼集群规模。灼识咨询30天满载压测显示:平台MFU(模型FLOP利用率)可达54.1%,日间波动率仅1.60%,优于行业常规区间。更高的算力利用率能够压缩训练周期、摊薄单位成本。平台推出独家DCU(1度算力)标准化计费模式,助力客户将总体拥有成本降低约 73.8%。其自研DART-GUI-7B拿下OS World 7B赛道全球第一,印证平台支撑高难度RL场景的工程实力。

九章智算云-训练算力利用效率
多方评估显示,九章智算云已成为国内科研机构、模型研发、物理AI开展大模型微调、强化学习训练的主流平台。
训推一致是这套体系的核心优势,落地难度远高于海外。海外NeoCould大多基于同构GPU集群搭建,而国内多芯片架构并存、软件生态割裂,极易出现“训得好、推不动”的断层。九章智算云的训练工厂与Token工厂共享Alaya OS+Alaya Atom Pod异构调度底座,训练阶段沉淀的算子、通信、集群优化策略可直接复用至推理,依托万卡级弹性集群支撑高吞吐推理服务。
面向Token规模化生产,九章智算云配套全套底层组件:自研DingoFS混合存储支持分钟级检查点,数百GB模型归档压缩至60秒内完成;叠加产品矩阵与DCU计量体系,将抽象算力转化为可计量、可交易的标准化Token服务,全量兼容国内主流开源大型,Token生产效率提升80%,已经在物理AI、科研等场景落地。
物理硬件编排构筑底层护城河。平台基于硬件拓扑感知就近分配任务,采用轨道优化互连与网络内计算技术,All-Reduce性能翻倍、流量减半;自动化容灾能力让千节点集群扩容耗时降低85%以上,节点配置提速7倍,把硬件纸面参数转化为稳定的生产算力。底层AIDC运营和上层MaaS服务互补,这也是它和算力租赁、API分销厂商最本质的区别。

九章智算云位居中国智算新云市场第一
九章智算云率先跑通全栈路径并实现高质量增长。灼识咨询口径,按2025年智算服务收入统计,九章智算云位居国内智算新云市场第一。
04
九章云极:异构环境下的中国方案
在全球NeoCloud能力图谱中,九章云极DataCanvas将算力供给、模型服务、AI 工程三层能力纳入同一框架,代表全球竞争语境下的中国方案。它的核心不是产品堆叠,而是打通异构算力、资源调度、训推交付的完整链路,直面算力本土化进程中长期存在的异构生态约束。
国内AI新云与生俱来的挑战,是多类芯片、驱动、编译框架长期共存,硬件无法互通。同一模型的运行表现,持续受算子适配、显存调度、通信框架、推理引擎制约。客户痛点早已不只是在算力资源,而是环境适配、算子调优、持续运维消耗大量研发资源。
九章云极依靠异构资源管理与云原生工程体系,覆盖异构算力、资源调度、训练推理、数据存储与性能观测,大幅降低AI落地摩擦。
算力供给层面,平台依托多容器集群适配多样化负载。面向训练场景,保障多卡多节点集群稳定运行,减少等待与任务中断;面向推理场景,按需弹性扩缩,规避高峰资源不足、低谷资源闲置,异构环境越复杂,调度价值越突出。推理链路中,PD分离、KV Cache复用、连续批处理等优化。这些技术的价值,最终需要在相同模型、相近硬件和一致工作负载下,以吞吐、时延、资源利用率及单位Token成本等指标验证。
AI工程层面,训练、推理、数据、调度是一体化闭环,完成从单项技术到工程协同。以具身智能研发为例,这类模型研发流程横跨数据采集、大规模并行训练、云端仿真、终端部署,算力需求波动明显。借助弹性能力,算力规模跟随研发阶段动态调整,削减闲置成本。
对九章云极而言,已经构建的异构生态工程能力,最终需真实业务的检验,体现在训练效率、推理性能、资源利用率与总体拥有成本等可量化指标上。
全球NeoCloud正沿着GPU供给,模型服务、数据中心基础设施和 AI 工程协同等不同路径演进,中国市场的增长为各类玩家提供了广阔空间。与此同时,驾驭复杂异构生态,既是中国AI新云厂商必须跨过的门槛,也可能成为构建差异化竞争优势的关键。
赛道竞争终将回归经营本质:能否稳定交付、控制成本,并持续降低客户的工程损耗,决定算力能否真正转化为可持续的服务价值。基本功的比拼,才是经营之道。
PPTV创始人再创业做“算力版滴滴”,日均消耗token超万亿,却难赚到钱?
(本文作者为 创业最前线,钛媒体经授权发布)
文 | 创业最前线,作者 | 于莹,编辑 | 王亚静
当AI大模型开始收费,卖Token的“工厂”逐渐成为市场最“吸金”的AI赛道之一。
在海外,被黄仁勋称为“AI工厂的台积电”的Fireworks AI7月拿到15.05亿美元融资,估值升至175亿美元;在国内,10月12日,上海AI Infra(人工智能基础设施)企业无问芯穹确认已完成23亿元C轮融资,累计融资额达43亿元。
资本追捧之下,做Token“工厂”的企业,开始走向大众视野,硅基流动、派想未来等企业纷纷向港交所递交上市申请。
其中,派想未来的创始人是曾创立了PPTV的“80后”学霸姚欣,他在退出ppvt后,在AI算力爆发前悄悄布局了算力赛道。
派想未来是一家独立分布式云计算服务商,业务始于边缘云计算服务领域,2025年营收已经达到7.7亿元。按灼识咨询口径,公司是中国最大的独立AI云计算服务商。
不过,公司至今尚未盈利,经营现金流也呈现净流出状态。而在可转股的条件压力下,公司上市需求十分迫切。
只是,这门在资本市场陆续拿到“大结果”的Token生意,底色究竟如何呢?
1、打造token工厂,要做“算力版滴滴”
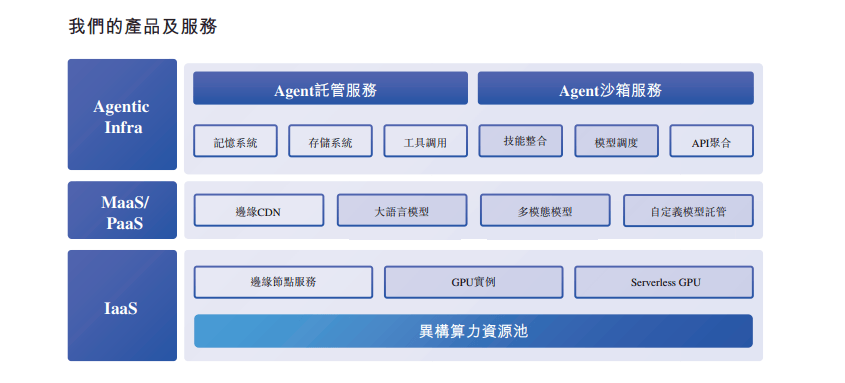
通俗来说,Token工厂就是专门规模化生产推理服务的“车间”,把电力、芯片、模型和数据,持续转化为可计量、可调度、可定价的模型调用能力。
而一般的传统云计算巨头,主要是“中心化大厂”逻辑,在全国建几个超级数据中心,通过长途光纤把算力输送给用户。这种模式,在需要超低时延、海量并发的5G和智能化时代,容易遇到物理瓶颈。
与阿里云、腾讯云等公有云平台不同,派想未来并非自建数据中心,而是通过“蜂群思维”搭建起中国最大的分布式算力网络。
公司发现,社会上存在大量分散、闲置、异构的第三方闲置算力资源,海量的算力需求与分散且尚未充分利用的算力供给之间存在重大错配。
所以,公司搭建了算力调度平台,把它们当成“私家车”,汇聚和管理异构资源的闲置算力,以最优方式向客户部署,从而加速内容传输及提升低延迟计算体验。
在接受采访时,创始人姚欣将公司比作“算力版滴滴”,称公司不采购、不持有大规模GPU服务器与数据中心,不自主搭建自有智算园区,全部算力资源向外采购整合,再通过自研分布式调度系统匹配供需。
(图 / 招股书)

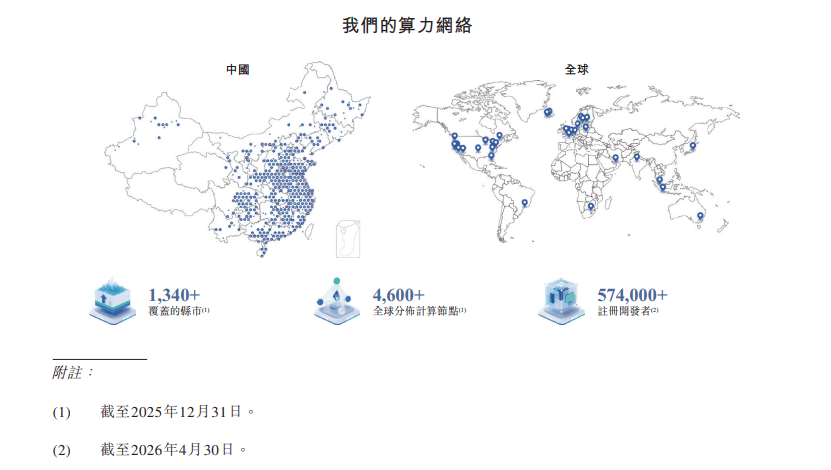
可以说,派想未来的核心资产不是硬件,而是一套极度聪明的分布式云计算架构和统一调度平台。正是通过这种调度能力,公司把全国1340多个县市的4600多个闲置节点盘活,成功构建起了一个边缘算力网络,把算力直接下沉到网络的最边缘。
(图 / 招股书)
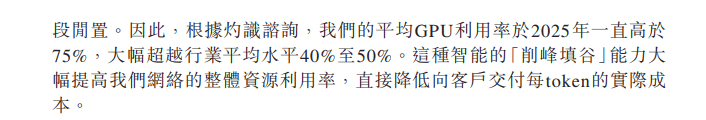
这种“轻资产、重调度”的模式,在2023年撞上了大模型爆发的超级风口。招股书显示,公司通过分布式调度后,GPU利用率在2025年一直超过75%,远高于行业40%-50%的平均水平,模型推理成本理论上可以下降超过80%。当AI时代来临的时候,这种优势被放大。
(图 / 招股书)
而打造派想未来,并非是姚欣的首次创业。
2004年,正在华中科技大学读研一的姚欣,为了解决同学们在宿舍看球赛直播卡顿的痛点,敏锐地捕捉到了P2P技术“人越多越快”的特性,索性休学创办了PPTV的前身PPLive。
在那个宽带和分发基础设施极度匮乏的互联网黄金年代,PPTV一度坐拥4.5亿全球用户,成了仅次于优酷的全国第二大视频平台,2014年PPTV最终被苏宁集团收购。
2018年,姚欣与当年的老搭档、华科学弟王闻宇再度联手,成立了派欧云计算(上海)有限公司(以下简称派欧云,派想未来在中国的合并联属实体之一),如今一起带领着派想未来冲刺资本市场。
招股书显示,IPO前,姚欣及其配偶吕姗姗,通过数家实体合计控制约48.05%的股份投票权;王闻宇间接持股10.17%,其他投资者包括Millennium、IMO Ventures、CCV Fund、华业天成、磐霖、沸点等。
2、营收2年翻倍,但为何越卖越亏?
目前,派想未来的商业模式采用云计算的收费模式,即按算力使用量或使用时长计费,主要付费客户包括大型互联网企业,以及中小型AI创业企业。
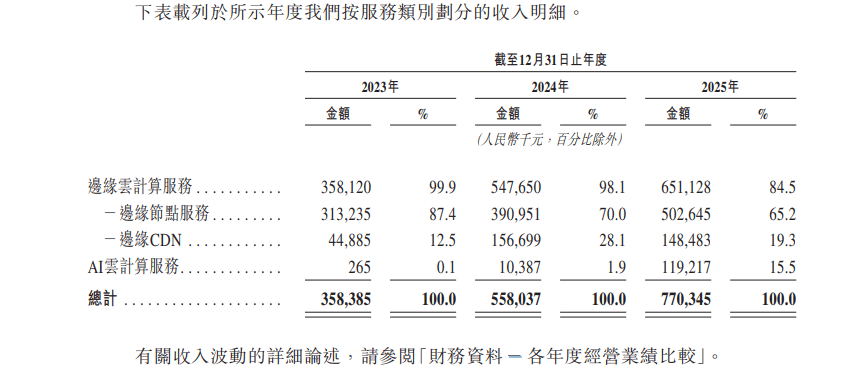
2023年至2025年(以下简称报告期内),公司收入从3.58亿元迅速增长至7.70亿元,复合年增长率达46.6%。
其中,边缘云计算服务收入(包括边缘节点服务、边缘CDN)分别为3.58亿元、5.48亿元、6.51亿元,长期占据总收入84%以上。
而AI云计算服务收入从2023年的26.5万元暴涨至1.19亿元,2025年同比增长超过10倍,占比提升至15.5%,成为招股书重点渲染的第二增长曲线。
(图 / 招股书)
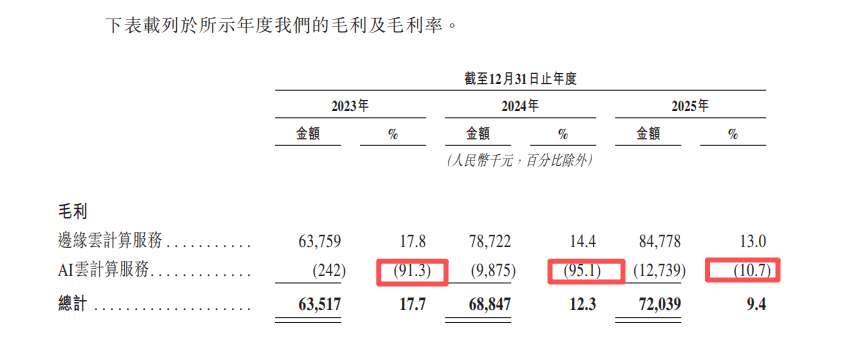
营收高增,毛利率却明显下滑。报告期内,其综合毛利率从2023年的17.7%滑落到2024年的12.3%,再到2025年的9.4%,近乎腰斩。
(图 / 招股书)
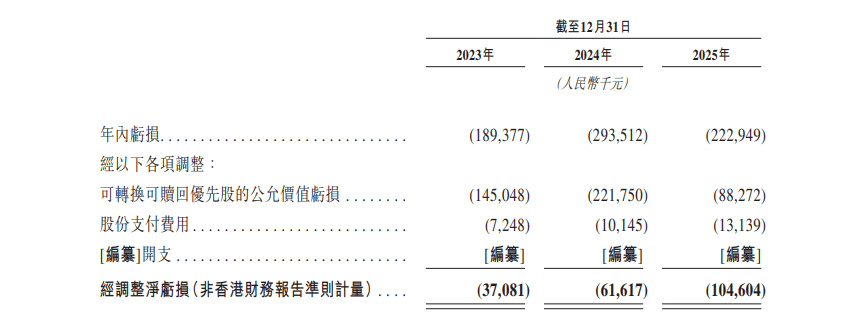
在这背后,公司一直深陷亏损之中。报告期内,其净亏损分别为1.89亿元、2.94亿元和2.23亿元。如果剔掉可转换可赎回优先股公允价值变动等非现金项,经调整净亏损仍从0.37亿元扩大到1.05亿元,陷入了“卖得越多,亏得越多”的境地。
(图 / 招股书)
造成亏损的根源,主要出在公司快速增长的AI云计算业务上。
2025年,其AI云计算毛利率为-10.7%,而2023年、2024年则分别为-91.3%和-95.1%,虽然毛利率亏损收窄,但至今仍是一笔“亏本买卖”,而其收入占比越来越高,拖累了整体毛利率表现。
「创业最前线」了解到,公司边缘云业务,主要是把算力放到离用户最近的地方,专门给视频、直播、文件下载做加速(也就是边缘CDN)。
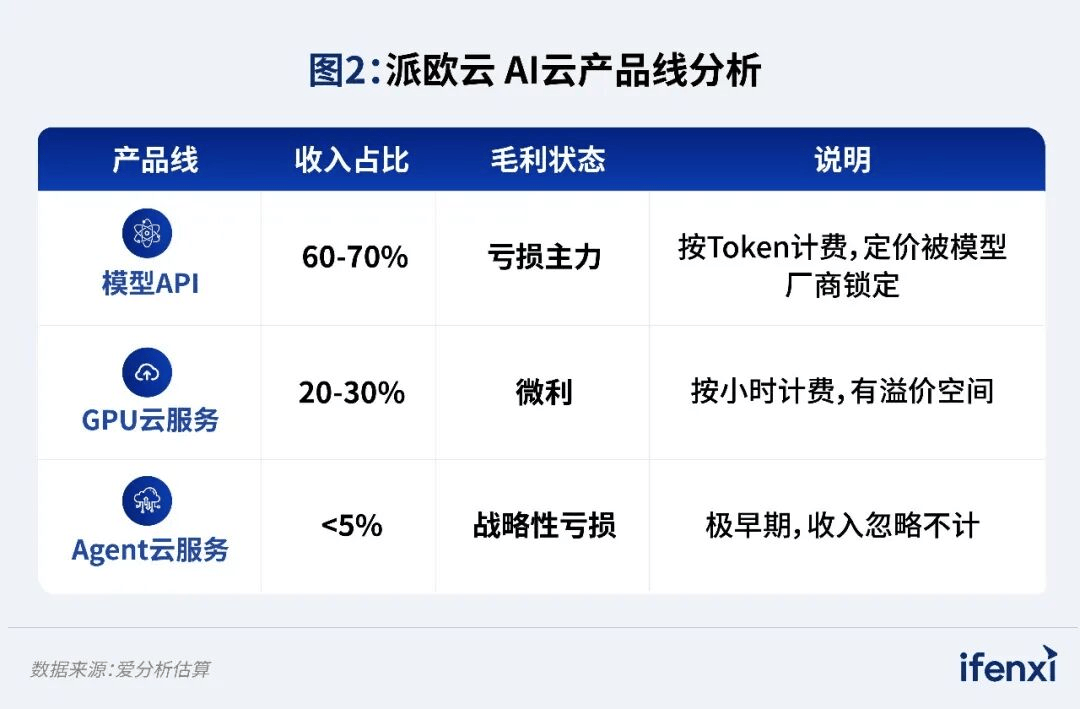
而AI云业务,则提供的是GPU算力和现成大模型接口(MaaS),客户不用自己买显卡、搭环境就能跑AI推理。但这块收入,主要来源于模型API,其为客户调大模型、按Token收费。
但Token价格并非为派想未来所定,而是模型官方定价。根据爱分析的报道,派欧云的定价页面和DeepSeek、GLM、Kimi等官方API文档定价一致。
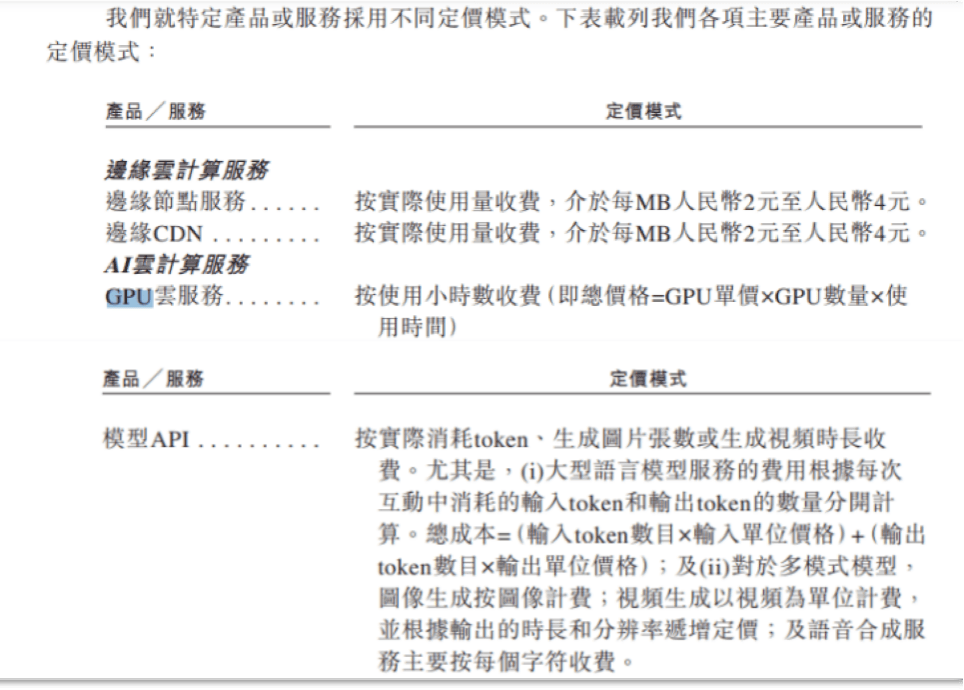
(图 / 爱分析(上)、招股书(下))
原因在于,定价权在模型厂商手里。Token API是同质化商品,用户切换Token供给方的成本、门槛极低。因此,即使大模型厂商的推理算力供给不足,派想未来也难以溢价收费。
而在成本端,派想未来的GPU算力多是租赁而来,2025年GPU资源成本1.17亿元,几乎追平了整体的AI云收入(1.19亿元)。可以说,公司每多提供一个Token,就要多付一笔GPU租金。
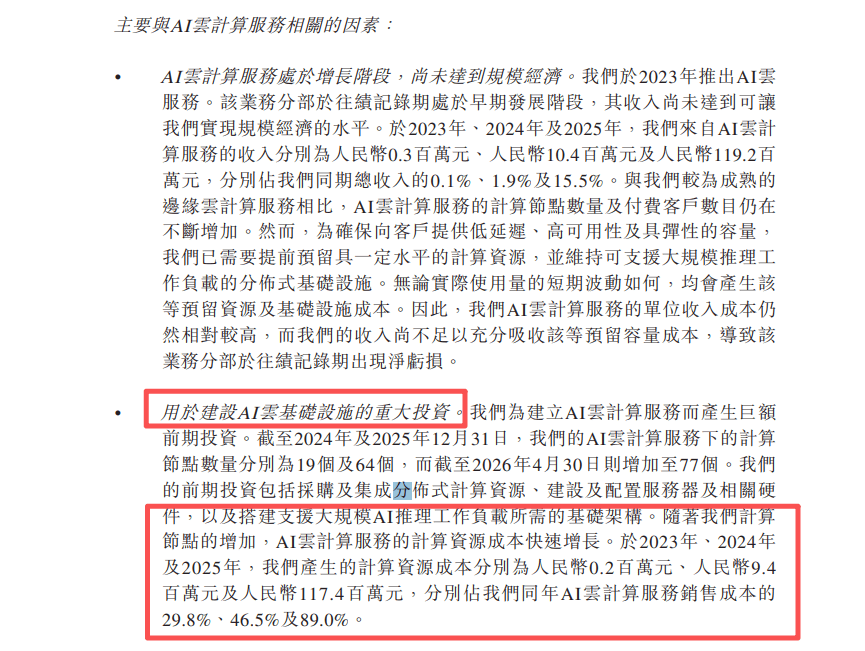
(图 / 招股书)
从这点看,虽然公司把自身比喻成“算力版滴滴”,但滴滴的抽佣定价权在自己手里,而派想未来上游是掌握定价权的模型厂商,下游是可以一键切换的客户,两头都被挤压。
不过,需求端确实是十分紧俏,公司披露的日均Token消耗早已破万亿,说明市场确实存在广泛需求,只是需求旺盛并不等于赚钱能力,公司的利润空间尚未打开。
在招股书中,公司也提示:“随着对公司产品及服务的使用量增加,客户可能要求降低定价,部分客户可能出于商业、合规或其他原因选择使用其他云服务提供商。为此,公司为维持或增加收入,或需要在销售及营销方面投入更多的支出,这些都会对公司的毛利率产生不利影响。”
可见,公司的低毛利率并非一时阵痛,是这套“租卡—转售Token”模式的天然限制。另外,算力中介赛道门槛低、同质化严重,派想未来若想突围并不容易。
3、上市倒计时,仅剩两个月时间
值得注意的是,公司的经营命脉,压在极少数大客户身上。
2023至2025年,公司的前五大客户收入占总营收比重分别达92.5%、89.5%、79.0%,营收高度依赖大客户。
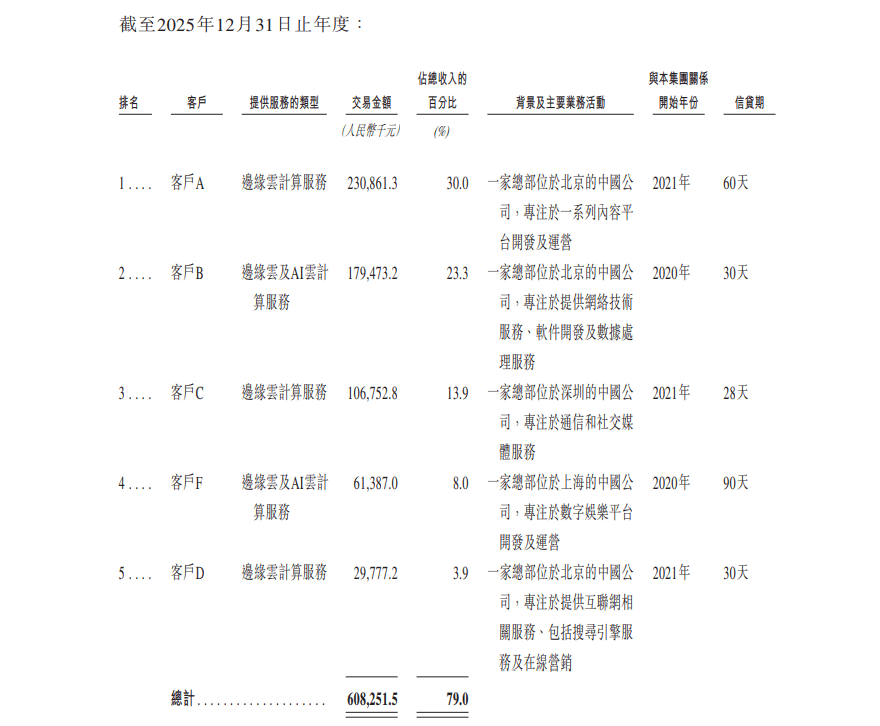
(图 / 招股书)
面对大客户,派想未来的回款周期较长,导致公司经营现金流持续为负。
招股书显示,公司通常向边缘云计算服务客户授予一至三个月的信贷期,2023年至2025年,贸易应收款项分别为0.9亿元、1.5亿元、1.68亿元。
同期,贸易应收账款周转天数分别为83天、79天及75天。报告期内,贸易应收款项中分别有93.6%、88.1%及74.9%为应收五大客户款项。
而从客户收取按使用量计算的费用,与向供应商付款之间通常存在时间差,从而导致潜在的经营现金流错配。报告期内,其经营现金流净额分别为-0.35亿元、-0.41亿元、-1.36亿元。
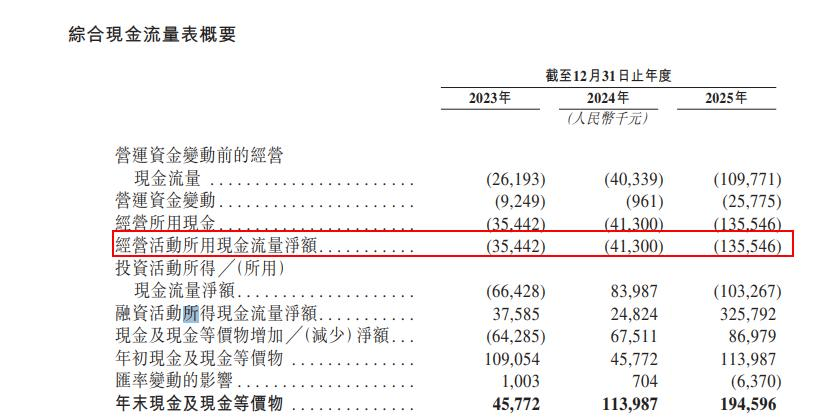
(图 / 招股书)
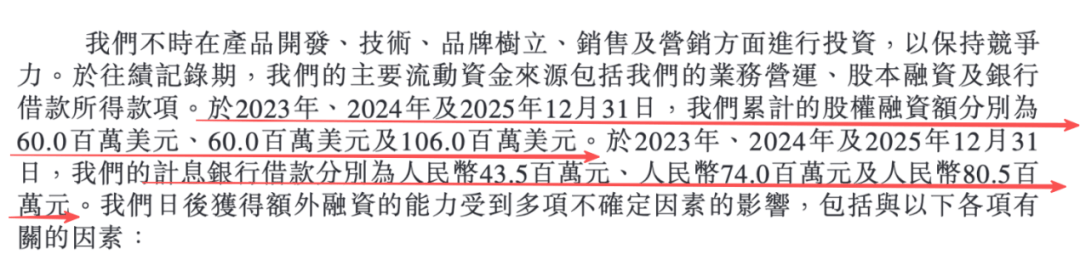
而公司运营颇为依赖融资。2023年至2025年,其累计股权融资额分别为0.6亿美元、0.6亿美元及1.06亿美元,计息银行借款分别为0.44亿元、0.74亿元及0.81亿元,逐年攀升。
(图 / 招股书)
此次港股IPO,公司拟将募资用于,提升公司于分布式云计算服务的技术能力及升级AI云计算服务;海外扩张,特别是在成熟市场及潜力尚未开发的新兴市场;战略投资及收购;营运资金及一般企业用途。
除了营运资金的压力,目前派想未来着急上市的原因,还有来自于悬在头顶的“赎回压力”。
招股书显示,派想未来的背后站着蓝驰创投、创世伙伴、华业天成等投资机构,以及早期重仓的百川智能王小川、前微软Azure中国区总裁申元庆、元气森林唐彬森。
从2021年天使轮后的4600万美元估值,到2025年B轮融资后的4.69亿美元,再到2026年5月底6月初刚完成的B-2轮,派想未来的投后估值已经达到5.76亿美元。
融来的钱虽然撑起了业务扩张,但也可能变成到期要还的债。当初为它背书的投资天团,此刻也正是手握赎回权的人。
2023年至2025年,公司分别录得可转换可
超智融合如何决定下一个十年科技发展丨ToB产业观察
如果把科研计算想象成一条流水线,那么过去几十年,这条流水线的节奏是由人来把控的,科研人员找到工具、写脚本、提交作业、盯着排队、排错重跑,最后再把结果一格格归纳出来。算力本身很强大,但喂给算力任务的方式却始终停留在手搓时代。
阿里云高性能计算&性能加速负责人游亮告诉我们,在当前的科研流程中,数据准备、环境配置、任务编排、结果分析等环节,80%以上的时间仍然依赖人工流转,真正用于计算执行的时间不到20%。
超智融合已是必然趋势
随着AI大规模进入科研流程,过去以HPC高精度计算为主的工作负载,如今叠加了AI训练、AI推理、智能体的通用计算,甚至还有智能体沙箱计算。
近年的诺贝尔奖已经出现了多个与AI直接相关的获奖成果,AI不再是科研的辅助工具,而是逐步进入观测、模拟、猜想与实验的各个环节,成为科研流程的关键组成部分。与此同时,传统HPC的高精度科学计算和AI模型的训练推理,正在同一个研究项目里并行出现,同一份研究,既离不开高精度的物理仿真,也离不开大规模的模型训练。IDC与浪潮信息联合发布的《中国人工智能计算力发展评估报告》显示,2024年中国智能算力规模达到725.3 EFLOPS,同比增长74.1%,远高于通用算力20.6%的增幅;该报告预计到2028年中国智能算力规模将达2781.9 EFLOPS,长期保持高速增长。IDC发布的另一份智算服务市场跟踪报告也显示,2024年上半年中国智算服务市场同比增长近八成,其中生成式AI基础设施服务增速超过200%。
在游亮看来,多种计算类型同时涌向同一个算力平台,传统HPC架构很难让它们同时做到性能最优、成本最低。更麻烦的是调度,传统HPC的调度逻辑是以作业为单位的,Slurm或PBS知道一个任务要多少核、多少内存、预计跑多久,但它不知道这个任务在科学上要解决什么问题。一个生物信息学研究者提交一个变异检测作业,调度器看到的是一个计算作业,看不到它处在一个从FASTQ到候选突变的完整链条里的哪一环,失败了应该换工具还是调参数,结果出来之后下一步该跑什么,这些判断全部留给人。
而现在,系统要同时调度HPC作业、AI训练推理、智能体任务和沙箱任务,这些负载的特征差异极大,高精度仿真吃双精度浮点性能和内存带宽,AI训练吃互联带宽和显存容量,Agent的工具调用和沙箱任务吃的是轻量、快速启停和弹性。传统HPC集群按照单一负载设计的架构,做不到让每一类计算都跑到最优,此时,传统的单一种类调度方式显然撑不住了。
如今,科研的流程正在从人驱动工具,走向人定目标、智能体自主执行,而这个新流程对算力的要求是:既要能跑HPC,又要能跑AI,还要能跑智能体,且必须统一调度、统一计量。谁能把这三种胃口不同的负载喂到一张桌子上,谁就拿到了下一代科研基础设施的入场券,而这也是超智融合得以被推到台前的原因。
超智融合难在哪?
超智融合看上去是将超算的服务器和智算的服务器连接起来,协同工作,但真做起来并不是那么简单。超智融合最直观的难点在精度和数据流动。气象预报、流体仿真、分子动力学通常需要FP64双精度来抑制累积误差,大模型训练和推理大量使用FP16、BF16甚至FP8,而Agent的沙箱和工具调用又涉及大量碎片化、短生命周期的轻量计算。传统算力体系将高精度计算与低精度计算割裂分离,难以满足混合精度计算、AI4S等复合型业务需求。精度不是“选一个档位”的问题,而是同一条科研链条上要在不同档位之间无缝切换。
游亮与我们分享了阿里云的解法,他表示,具体可以拆成三层来看。
第一层,让不同的算力各得其所,又连成一张算力网络。游亮介绍,阿里云的思路是面向不同的工作负载提供最匹配的实例类型。比如,面向传统HPC,提供HPC优化实例,面向AI训练和推理分别提供对应的AI加速实例,面向智能体提供通用计算和容器实例等。关键在于,这些异构实例通过云上统一的虚拟网络串联成一张“算力网络”,并借助CIPU 2.0架构实现无虚拟化损失的资源调度,再通过统一的开放OpenAPI,让所有算力可以被统一创建、调度和编排。
在CPU层面,阿里云打造了hpc9a,其搭载第五代AMD EPYC(Turin-C)处理器,最高睿频5GHz,128个物理核心,内存可达3TB,依托CIPU2.0架构消除虚拟化损耗,配合200G的低时延eRDMA网络,相比上一代性能提升约30%。
游亮介绍,hpc9a专门面向CAE仿真、电子设计自动化这类对计算性能、内存带宽和网络时延都极度敏感的场景。AI侧则交出了平头哥自研芯片的成绩单:M890P相比上一代性能提升至3倍,新一代V900又在此基础上再提升至3倍性能。配合超节点架构和弹性算力,E-HPC可以为科研场景提供从单卡到大规模集群的AI加速能力。
在智算方面,阿里云则在自研芯片的道路上有所收获,其推出的M890P相比上一代性能提升至3倍,新一代V900又在此基础上再提升3倍。配合超节点架构和弹性算力,E-HPC可以为科研场景提供从单卡到大规模集群的AI加速能力。
性能与成本的平衡靠两条腿走路。一是多代实例并存,客户按工作负载选择性价比最高的实例规格;二是云的弹性,客户在业务波峰需要上千台实例,波谷可能只需要几十台,传统模式必须按峰值预留资源,云上则可以按需创建和销毁,让性能与成本同时逼近最优。游亮与我们分享了一个案例:阿里云与国内某头部乘用车公司深入合作,通过HPC优化实例、弹性eRDMA低延迟网络,叠加CPFS并行存储优化,端到端帮助客户节省了约25%的计算周期,大幅提升了工作效率。

第二层是让数据跑得比算力快。算力再强,数据喂不上就是空转。游亮介绍,eRDMA负责让节点之间沟通速度越来越快,CPFS负责让HPC计算、分布式AI训练和推理等负载,用最快的时间拿到数据,让计算饱和运转,把昂贵算力的浪费降到最低。存储侧的优化包括冷热分层,把常用数据放进缓存层,使用时不必再从远端存储拉取,以及让网络邻近、存储邻近的计算节点做亲和性调度。
第三层是让智能体替人跑完执行流程。围绕超算与智算持续融合、AI在科研中作用攀升、人工流程成为瓶颈等趋势,阿里云推出了E-HPC智能体平台,其架构从上到下分为四层:最上层是面向具身智能、生命科学、CAE、EDA、量化、渲染等行业的智能体;行业接入层把行业知识和专家方法沉淀为Skills,供智能体调用,同时提供命令行、开放API和SDK;中间是统一的Agent Runtime,负责理解科研目标、规划任务、用skills实际执行、依据日志和结果反馈再规划;往下是E-HPC执行层,统一承担作业编排、异构资源调度、环境与数据准备以及状态日志管理,并调度CPU、GPU、eRDMA网络、镜像软件与安全治理资源。
通过搭建这三层架构,目前阿里云已经在超智融合方面有所收获。在具身智能场景,RoboAgent打通了端侧数据采集、数据处理标注、模型训练推理、远程仿真到部署回传的完整链路,一站式降低数据准备成本;某具身领域头部企业借助这套方案,实现了从真机采集上传、多模态标注处理到QwenVL等多类算法训练的快速闭环。
在生命科学场景,BioAgent根据研究目标自动编排WDL工作流,自主识别FASTQ、PDB等数据格式并推荐分子模拟参数,调用GATK、GROMACS等工具并智能匹配CPU/GPU资源,让生信与药研流程可复用、可解释、可持续迭代;最具代表性的是上海科学智能研究院旗下格物智研的“浑天绫”,这个编排出140多个科研skills的物质科学智能研发平台,与阿里云E-HPC的弹性算力底座配合,把分子筛选任务从数据检索、算力调用、分子对接、FEP计算到自动化合成,这些以前由人工串联的环节,现在全部由智能体自主完成。
在CAE场景,工程师只需聚焦设计判断,前处理、求解、诊断、后处理与参数探索由Agent自主贯通。
要实现这些也并不是一蹴而就的,游亮也坦言,最大的挑战在于不同行业对算力、精度、实现方式的需求各不相同,需要把各行业的专家经验和行业知识沉淀为skills,同时把E-HPC在调度、编排、任务识别、资源匹配上的专家能力也沉淀为平台skills,再通过统一的Agent Runtime承接两者,并解决行业skills与E-HPC skills的协同、海量算力拉起、行业负载与算力负载最佳匹配等难题。他的总结是:行业Agent可以非常稳定、弹性、可观测、可治理地调用阿里云的HPC服务,而这背后需要反复打磨每一层。
更值得关注的是,E-HPC已经不只是通用算力平台,而是针对芯片设计、AI4S与生命科学、具身智能三个重点行业形成了专属解决方案。面向芯片设计,E-HPC混合云可以无缝对接企业现有的LSF、Slurm、PBS调度环境,云上云下统一调度、按队列自动扩缩容,工程师无需改变使用习惯,就能在仿真验证高峰随时补齐算力;针对STA、PR等大内存作业,大内存HPC实例可以直接承接,帮助芯片团队守住流片周期、优化整体拥有成本。面向AI4S与生命科学,E-HPC预集成AlphaFold3、OpenFold3、RFDiffusion、GROMACS、GATK等主流科研软件,开箱即用,客户自有的科研Agent还能通过CLI、API或Skill直接调用弹性算力,把药物发现、基因分析从繁琐的环境搭建中解放出来。面向具身智能,HPDA Robotics将采集、管理、标注、训练、仿真、推理串成一条完整数据闭环,内置APAK加速引擎,多模态数据处理的性价比可提升2.1至5倍,显著缩短数据准备与模型迭代周期。三套专属方案共享同一张弹性算力网络和同一套调度、存储与安全能力,既能开箱即用,也能平滑接入客户现有环境。
更值得关注的是,E-HPC已经不只是通用算力平台,而是针对芯片设计、AI4S与生命科学、具身智能三个重点行业形成了专属解决方案。面向芯片设计,E-HPC混合云可以无缝对接企业现有的LSF、Slurm、PBS调度环境,云上云下统一调度、按队列自动扩缩容,工程师无需改变使用习惯,就能在仿真验证高峰随时补齐算力;针对STA、PR等大内存作业,大内存HPC实例可以直接承接,帮助芯片团队守住流片周期、优化整体拥有成本。面向AI4S与生命科学,E-HPC预集成AlphaFold3、OpenFold3、RFDiffusion、GROMACS、GATK等主流科研软件,开箱即用,客户自有的科研Agent还能通过CLI、API或Skill直接调用弹性算力,把药物发现、基因分析从繁琐的环境搭建中解放出来。面向具身智能,HPDA Robotics将采集、管理、标注、训练、仿真、推理串成一条完整数据闭环,内置APAK加速引擎,多模态数据处理的性价比可提升2.1至5倍,显著缩短数据准备与模型迭代周期。三套专属方案共享同一张弹性算力网络和同一套调度、存储与安全能力,既能开箱即用,也能平滑接入客户现有环境。
智能体将成为科研的操作系统
通过阿里云所搭建的三层架构,可以看出当前超智融合的发展路径。技术侧,算力会继续变大,传输通道会继续变长。 游亮透露,在Scale Up方向上,阿里云上超节点由几十到上百颗AI芯片组成,未来超节点支持更大规模;在Scale Out方向上,通过弹性RDMA网络实现跨节点、跨可用区的互联。
超节点本质上可以被看作一个巨大的AI算力节点,其规模上限的持续抬升,将直接决定大规模训练与仿真的效率。与此同时,eRDMA与传统RDMA的区别在于它能承载更广泛的互联,从超节点内部延伸到跨可用区场景,这正是“算力网络”想象的物理基础。
应用侧,智能体将从可选项,变成行业标配。阿里云 E-HPC的产品逻辑已经从单点智能体走向体系化:各个行业Agent负责各自领域的专业执行,WorkAgent则把分散在各行业的智能体统一收敛成一套目标驱动的执行闭环,科研人员只需要说清“算什么、要多准、多久出结果、花多少钱”,WorkAgent负责翻译成计算任务和验收标准,自动拆解流程、引入专家经验、匹配算力网络与存储资源,最后解析日志收敛曲线与关键指标,定位失败并给出改进方向。“人只需要给目标、做判断,重复的工作流程交给智能体自主完成。这一步的意义在于:企业不必重复建设行业智能体和算力底座,而是像水电一样接入。”游亮如是说。
阿里云是超智融合领域最具代表性的企业之一,但并不是唯一家。传统超算阵营里,国家超算中心与硬件厂商正沿着各自平台推进HPC与AI方法的深度融合;AI厂商则以智算集群和万卡训练平台为主攻方向;运营商大规模建设智算中心。IDC数据显示智算集成服务市场正以超过150%的增速扩张,市场格局远未定型。
值得注意的是,各家的打法虽不同,但方向高度一致:让HPC与AI在同一个平台里协同工作,让智能体成为科研的默认操作系统。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App
奥特曼:PC上装内存太浪费,最好留给AI数据中心
AI“完美风暴”剧本:债市“吹响号角”,财报“雪上加霜”,中选“最后一击”?
决定下周市场走势!美国中选“最大悬念”:共和党意外守住参院 vs 民主党取得53席以上
[程序员] 压缩的尽头是自指?从 LZMA2、PAQ8PX 到 zstd/ZIP/RAR Quine,我折腾了一遍“自包含压缩包”
最近把之前关于压缩的各种折腾整理成了一篇长文,发在博客上,想搬来论坛和大家聊聊。
一开始只是想给博客离线包找更强的压缩算法:7-Zip 的 LZMA2 已经很能打,但我不信邪,又试了 ZPAQ 、PAQ8PX 、NNCP 、cmix 。结果挺有意思:
- ZPAQ:一分钟左右把 16MiB 压到约 3.5MiB ,老算法但速度和压缩比还挺平衡;
- PAQ8PX:压到约 3.1MiB ,本次冠军,但花了一个半小时、吃了 30GiB 内存,解压同样痛苦;
- NNCP:FFmpeg 作者 Fabrice Bellard 的 Transformer 压缩算法,RTX 4090 上跑了一个半小时,结果 4.1MiB ,还没 LZMA2 高;
- cmix:测试时压到一半崩溃,内存和耗时也很夸张。
结论大概是:追求极限压缩比,PAQ8PX 很强;日常使用,LZMA2 的 7-Zip 依然是最稳的选择;想在小文件上再挤一点,ZPAQ 可以试试。
更有意思的是后半篇:继续折腾“自包含压缩包 / Quine 压缩包”——也就是压缩包里包含一份和自身字节完全相同的副本。之前做过 7z Quine ,这次又让 AI 研究了:
- zstd Quine:利用可跳过帧、RAW block 和 XXH64 校验值构造,最终做成
.tar.zst,Windows 资源管理器也能直接打开;文章里附了完整生成代码; - ZIP Quine:利用成员数据重叠绕过窗口限制,7-Zip 和 libarchive 能正常解压,但 Python
zipfile会因为检查压缩数据越过后续局部头而报错,算是一点兼容性代价;文章里也附了生成器; - RAR Quine:原理上也能做,AI 也生成出来了,但因为 RAR 不是开源软件,文章里只放了生成后的样例供研究。
文章里还有一段让我挺感慨的:这些代码我基本看不懂,但 AI 就是能把问题解决。复杂格式、校验值构造、兼容性坑,全都硬啃下来了。于是最后也忍不住写了点关于 AI 和“记录还有没有意义”的感想。
原文在这里:《关于压缩的各种探索》
感兴趣的朋友可以聊聊:
- 你用过最离谱但确实有效的压缩算法是什么?
- 极限压缩比和可用性之间,你会怎么选?
- 对这种“压缩包包含自身”的 Quine 玩法,有没有其他格式可以继续挑战?
- AI 生成这种复杂但能跑的代码,你觉得是解放生产力,还是让人越来越看不懂基础设施?
欢迎拍砖、补充算法和格式,也欢迎试试文中的 zstd/ZIP 生成器~
[程序员] 我在 2 核 2G 云主机上跑 OpenViking:一次关于云主机、模型选型与长期成本的真实复盘
最近把自己的 AI Coding Agent 记忆底座迁移到了自建的 OpenViking 上( OpenViking 真的满足我所有的要求:即是各种 Agent 的统一大脑自进化、又是知识库,检索的时候是两方面综合起来的)。RAG 相关的东西看着挺吓人,动辄推荐高配服务器和本地显存,实际上用下来,只要选型想清楚,一台几十块钱的入门级云服务器完全能跑得飞起。
这篇不是教你怎么敲命令的安装教程,只是聊聊折腾这一圈下来,在云主机、模型组合、算力开销上的一些真实心得和踩坑取舍。
1. 云主机:为什么我选 99 元的 2G ,不选友商更便宜的 4G ?
买云服务器时,第一眼很容易被一些友商“几十块钱买 4G 甚至 8G”的新客促销吸引。但我最终还是选了阿里云 99 元/年的 2 核 2G ( ecs.e-c1m1.large )。
核心原因就一个:算长期的续费账,避开“首年低价、次年暴涨”的套路。
如果只是搭个无状态的个人博客,一年一换、到处搬家无所谓。但 OpenViking 是你的记忆数据库,里面存的是日常所有的会话轨迹、沉淀的项目架构、实体图谱和向量索引,是强状态资产。很多友商首年 60 块,第二年续费直接跳到 600 、800 甚至上千,一年后为了省钱被迫停机、跨云拷贝几千兆数据、重新配安全组和域名解析,折腾成本远超那点差价。
阿里云这款活动最大的诚意,是保证来年依然可以 99 元无套路同价续费。
2G 内存虽然紧凑,但只要做好 Swap 兜底,限制好容器内存,并把计算全都甩给外部 API ,机器本地只做存储检索,日常内存占用常态也就几百兆。拿稍微调优一下系统为代价,换一个每年只要 99 块、不用频繁搬家的稳定记忆底盘,这笔账怎么算都更划算。
2. 向量模型( Embedding ):花钱的大头,必须一步到位
整套系统跑起来,持续花钱的大头其实就是向量模型。但我从一开始就放弃了“白嫖免费模型”的想法,坚定选择花钱买商业服务,并且要“一步到位”。
为什么必须一步到位?
VLM 、意图分析、重排模型这些都是即时推理,今天觉得不好用,改一行配置重启一下直接就换了。但向量模型决定了数据库底层的空间几何特征。一旦以后你想换向量模型,哪怕输出维度一模一样,之前的向量也全都废了,必须全库全量重建索引( Re-index )。随着记忆越积越多,二次重构的代价和停机风险极高,所以向量模型选型必须一开始就选最好的。
为什么放弃 SiliconFlow 免费的 BGE-M3 ?
很多教程推荐用硅基流动上免费的 BGE-M3 。我们在实际做向量召回测试时发现,它的召回质量被新一代模型拉开了非常明显的代际差距。BGE-M3 是 2024 年 1 月的模型,底子太老,而且是个纯文本模型,图片只能当附件存,根本建不了索引,做不到“以文搜图”。
更关键的是,公用免费池已经被羊毛党挤烂了。我们在测试免费模型做路由时频繁遇到丢包、高延迟、无响应。作为核心基础设施的底座,把身家性命系在免费公共池上,纯属给自己找麻烦。
为什么选火山方舟的豆包 Vision ( 0.7 元),没选阿里千问?
最终我用的是火山方舟的 doubao-embedding-vision-251215,官方定价是推理输入 0.7 元 / 百万 tokens。
其实阿里百炼也有一款多模态向量模型(qwen3-vl-embedding),价格一模一样也是 0.7 元,但两者有个致命差距:
- 阿里千问的上下文窗口只有 32K;
- 火山豆包的上下文窗口高达 128K。
对于 Agent 场景,经常要塞入长篇开发规范、长上下文代码切片或者多张高清截图,128K 带来了整整 4 倍的安全容限,彻底不用担心超长切片溢出。加上 OpenViking 本身就是字节火山引擎开源的,原生 Provider 兼容最稳,同价位下显然选 128K 的豆包。
注:如果你完全没有图片、截图的检索需求,只做纯文本或代码笔记,阿里百炼的纯文本向量 qwen3.7-text-embedding 是个很好的省钱备选,价格只要 0.5 元/百万 tokens 。
3. 意图分析( Query Planner ):90% 的人都漏看的“隐藏开关”
很多人刚用 OpenViking 时都有个共同的困惑:“为什么这玩意儿响应这么迟钝?每次在 IDE 或终端里刚敲完一句话,光标都要卡顿个五六秒才开始有反应?”不少人甚至因此觉得是机器配置不够,或者系统本身设计笨重。
其实根本不是性能问题,而是绝大多数人压根没仔细看配置文档,不知道还能单独配一个意图分析模型。
官方默认示例里大家一般只填 vlm 和 embedding。但只要没在配置里显式声明 query_planner,OpenViking 在处理每一轮对话时,就会默认回退去调用主模型 VLM 来分析这轮对话是不是闲聊、要不要搜记忆、怎么提取关键词。如果你的 VLM 选了个大模型或者带思考链的模型(比如智谱 glm-5.3-flash),单次前置分析直接就能吃掉 6~7 秒,前端交互自然卡成 PPT 。
为了解决这个前置卡顿,起初我试图在主流的通用大模型里寻找替代方案。但跑了一圈下来非常沮丧:
- 阿里百炼官方的 Qwen3.7-Flash 默认带深度思考,跑一次要想 10 秒;
- 硅基流动上的 Qwen/Qwen3.5-9B 吞吐偏慢(常态 30 tok/s ),每次提问依然要停顿 4 秒;
- 硅基流动上的 Qwen/Qwen2.5-7B 格式飘忽,爱吐裸数组;
- 硅基流动公用免费池的模型(如 Qwen3.5-4B)更是被羊毛脚本挤爆,频繁丢包超时。
正当我们卡在通用大模型的选型瓶颈时,**我在阿里百炼模型广场里无意间翻出了一个宝藏模型——tongyi-xiaomi-analysis-flash(伶鹊-对话分析-flash )**。官方介绍写得很朴实:专攻对话信息抽取、场景分类与低时延分析的领域模型。
我立刻把它拉进测试矩阵,和前面的候选模型来了一场同台竞技。需要特别说明的是,为了公平对比,我们在压测所有候选模型时,全都显式关闭了思考模式(开启非思维链模式,纯直接输出)。
在实际评估中,我们重点死磕了三个核心维度:响应耗时、生成结构、规划表现。在三项严苛检验下,这个意外淘到的宝藏模型给出了教科书级的表现:
维度一:响应耗时(时间预算必须死守在 1 秒内)
query_planner 处于用户敲下回车、模型真正回答前的关键阻塞路径( Critical Path )上,耗时哪怕多 1 秒,体感都是极其明显的卡顿。
- 阿里百炼 Qwen3.7-Flash:即使关掉思考模式(
enable_thinking: false),单次分析依然要 1.1~1.4 秒( 70~90 tok/s ),作为高频前置拦截还是略重; - 硅基流动 Qwen/Qwen3.5-9B:关掉思考后,受限于供应商 30 tok/s 的生成吞吐瓶颈,跑完一段多轮分析依然需要 3.8 ~ 4.2 秒;
- 硅基流动免费池(如 Qwen3.5-4B ):公用免费池常年被羊毛脚本挤占,延迟严重抖动甚至直接超时;
- 通义伶鹊( Flash ):首字延迟( TTFT )仅 0.31 秒,生成吞吐高达 200+ tok/s,整轮规划耗时直接干到了 0.8 秒左右,完美落在亚秒级预算内。
维度二:生成结构(严苛遵循 OpenViking 要求的 JSON 协议)
OpenViking 底层的意图解析器对输出格式有明确的契约要求:模型必须返回形如 {"queries": [...]} 的标准 JSON 对象结构(由内部代码直接反序列化提取检索意图),容不得半点格式偏差:
- 通用大模型的通病:喜欢画蛇添足加礼貌用语(“好的,为您规划如下”),或者在外面套一层
json ...围栏,把本该干净的输出搞得拖泥带水,全靠系统写正则兜底去清洗; - 硅基流动 Qwen/Qwen2.5-7B 的硬伤:虽然速度压缩到了 1.8 秒,但格式极其不服从规范,经常丢掉 OpenViking 要求的顶层 Key ,直接吐出一个裸数组
[...]。一旦丢了对象结构,极易触发解析异常导致检索失败; - 通义伶鹊( Flash ):官方特性主打“自定义分析标准遵循”,实测下来对 OpenViking 要求的 JSON 协议做到了 100% 严格执行——输出纯净裸 JSON ,没有 markdown 围栏,没有前后废话,与 OpenViking 的反序列化契约严丝合缝。
维度三:规划表现评估(业务意图的决断质量)
意图分析模型绝不是盲目生成检索词,它必须具备清晰的业务场景决断力:
- 闲聊拒搜率:面对“你好”、“谢谢”、“帮我写个冒泡排序”这种无需长程记忆介入的输入,通义伶鹊能像防火墙一样在 0.4 秒 内果断断定无需检索,并输出空数组
{"queries": []},避免了无意义的向量库查询与上下文污染; - 多轮指代消解与实体抽取:在多轮对话中(比如用户追问“把刚才说的那个服务端口发我”),它能从历史上下文里把代词精准还原成具体的实体词(展开为“OpenViking 1933 端口配置”),提取出来的 Query 极其精准紧凑,绝不发散脑补。
事实证明,这个无意间淘到的宝藏模型绝非侥幸胜出,而是其专攻“对话抽取、场景分类、格式遵循”的垂直微调定位,正好与 OpenViking 前置路由的工程诉求完成了教科书般的精准对齐。
4. 重排序( Rerank )与 VLM:务实的经济账与容灾
最后说说剩下的两个组件:
- 重排序( Rerank ):我依然放在了硅基流动上,用的是
Qwen/Qwen3-Reranker-4B。 之所以用它,是因为它走的是轻量商业计费通道(避开了免费池的排队),调用一次只要几厘钱。关键是我账号里还有送的 16 块钱代金券,不用白不用。实测 4 条文档打分 0.26 秒,30 条文档打分 0.57 秒,速度快而且打分很准,性价比拉满。 - VLM (多模态语义抽取):用的是智谱 Coding 套餐里的
glm-5.3-flash,顺便配了双 Key 主备容灾。 这里有个极其关键的实战经验:配置里一定要把思考模式显式改为reasoning_effort: "low"。 我们专门做过多组 A/B 实测,默认不传参或者设为high时,模型会先深度思考大几十秒(耗时 20~48 秒,生成上千个无意义的思维链 Token ),而最终提取出来的实体和概览内容与low几乎毫无区别。记忆提取本质上是信息抽取和结构化归档,根本用不着复杂的数学逻辑推演,开high纯属白白浪费时间和算力。 即使设为low,单次抽取依然需要 4~6 秒(有底层基础思考和 20~30 tok/s 的吞吐上限),它也是目前系统唯一的耗时点。但因为 VLM 只在后台异步做会话归档和概览生成,完全不阻塞前端的提问交互;加上 Coding 套餐按年付费极度便宜,配合双 Key 容灾非常稳定,现阶段完全不需要花钱折腾换它。
5. 写在最后的一些大白话心得
折腾完这套配置,最大的几点感悟:
- 状态型服务,买服务器先看续费:做长期记忆库,宁可前期在 2G 上花点时间调优,也别为了贪图首年几块钱的便宜去买续费暴涨的机器,搬家真的很累。
- 核心资产一步到位,无状态节点随时优化:向量模型决定了你的底层空间,别贪免费,多模态 + 大上下文( 128K )直接锁死,避免以后二次重建;而 VLM 和 Rerank 这种纯推理节点,谁快谁便宜就换谁。
- 专用小模型在垂直场景吊打通用大模型:意图分析这种讲究“分类、提取、严格 JSON 格式、极速”的任务,微调过的对话分析小模型比动不动就写小作文、开思考链的通用大模型好用太多倍。
好莱坞最缺的答案,被这家 10 亿美元估值的 AI 影视独角兽写进了片单

Edge AI Daily 早报(11月1日)
(本文作者为 Edge AI Daily,钛媒体经授权发布)
硅谷前沿:
1.【市场表现】10月30日纳斯达克综合指数跌2.6%收于26008.86点,10月累计跌5.3%;同期标普500科技板块跌6.8%、费城半导体指数跌15.4%,均创2025年3月以来最差单月表现;10月30日科技板块领跌标普500,单日跌4.24%。
2.【财报与现金流背离】Meta三季度营收646亿美元、同比增26%超预期,但单季资本开支349.1亿美元近翻倍,经营现金流327.9亿美元难以覆盖,自由现金流首度转负至-21亿美元,财报后股价跌约7%;Alphabet维持2026年资本开支1950亿至2050亿美元指引,Amazon过去12个月自由现金流流出424亿美元、预计2026年资本开支约2200亿美元,两家同样遭抛售。
3.【投资逻辑切换】高盛策略师Amanda Lynam称,Meta、微软、亚马逊、Alphabet四家2026年合计资本开支将达7250亿美元,较2025年4100亿美元增77%;市场估值逻辑由“收入增长”转向“现金回报”,边际回报下降,CoreWeave月跌37%、Nebius跌35%等纯AI叙事股首当其冲,现金流强劲、AI投入可控的公司更抗跌。
1.标普评级动作:2026年10月30日,标普全球评级将Meta的“AA-”长期发行人评级展望由稳定下调至负面(评级本身维持),使其成为四大超大规模云厂商中首家因AI基础设施支出被“亮黄牌”的公司;理由包括Meta的AI变现能力弱于同行、杠杆率最快2027年升破1倍(去年约0.1倍,警戒线为1.0倍),标普预计其2026年资本支出约1400亿美元、2027年加速至2250亿美元以上;Meta发言人回应称“恭敬地不同意”标普对其AI变现能力的判断。
2.现金流逆转:2026年三季度(10月21日公布)Meta自由现金流为-21.2亿美元,为2012年以来首次转负;当季资本支出349.1亿美元(含融资租赁本金偿付),超过327.9亿美元经营现金流,公司将2026年资本支出指引下限由1300亿美元上调至1350亿美元(上限1450亿美元)。标普测算其自由现金流缺口2026年220亿美元、2027年扩大至710亿美元、2028年仍为390亿美元,即2028年前难以回正。
3.市场与行业定价:10月22日Meta五年期CDS利差扩大7.6个基点至114.79个基点的历史新高,同日股价跌7.0%至648.85美元;至10月30日收614.99美元,较52周高点779.82美元回落约23%(标普行动当日纳指100跌3.5%)。行业层面,2026年五大云厂商AI相关资本开支合计预计超4840亿美元、同比增逾30%,美银预计八家巨头合计自由现金流由2025年正的1800亿美元转为2026年-640亿、2027年-1440亿美元,融资结构转向发债、股权与合资。
1.OpenAI两周内两次下调本轮融资目标:由以1.4万亿美元估值募资300亿美元,降至以1.25万亿美元估值募资约200亿美元;今年3月其刚以8520亿美元估值完成1220亿美元融资。
2.营收口径引发预期差:OpenAI披露截至9月底年化营收约500亿美元,较此前流传的680亿至700亿美元低约180亿至200亿美元,落差主因统计口径差异(高值用总额法计入云渠道分成以对齐Anthropic口径);据《金融时报》,公司2026至2030年累计负自由现金流或达2780亿美元。
3.资本开支大幅收缩并传导市场:2030年前算力基建支出目标从1.4万亿美元砍至约6000亿美元(降幅约57%,年均约1000亿美元);营收不及预期消息公布后,纳斯达克综合指数当日跌逾1%,英伟达跌约3%、甲骨文跌逾5.5%,市场定价逻辑由“算力规模”转向“收入与资本开支之比”。
1.2026年10月31日,Anthropic向美国证券交易委员会提交IPO招股文件,披露近9000亿美元表外未来义务(服务器、数据中心、电力及GPU采购),远超其账面1175亿美元负债与1120亿美元现金,被分析师称为“隐性债务”。
2.承诺规模半年激增:截至2026年6月30日,固定或最低采购承诺约2656亿美元、已签未执行租约约3214亿美元,合计约5870亿美元,较2025年底约1050亿美元增约5.6倍;订单集中于Broadcom、Google、Amazon、Microsoft等七家供应商。
3.财务与影响:2026上半年营收162.86亿美元(同比约增1300%),二季度营业利润首次转正,但净亏损807亿美元、基础设施支出由23.34亿升至89.45亿美元,上半年融资1108亿美元;市场传IPO估值约1.5万亿美元(低于此前2万亿预期),AI支出担忧拖累亚马逊、Alphabet、微软股价。
1.英伟达正与英国AI云服务商Nscale谈判,拟为其西弗吉尼亚州Anthropic数据中心的债务融资提供数十亿美元信用担保(“剩余价值担保”,规模或超50亿美元):若Nscale拖欠建设款,英伟达将接管设施并寻找买家。这是其首次将信用支持从租赁、芯片采购延伸至电力与建筑建设环节。
2.Nscale已于2026年9月18日递交S-1,拟最高350亿美元估值登陆纽交所,较3月的146亿美元半年涨约2.4倍;但合同订单达1030亿美元,2026上半年实际营收仅1.406亿美元、净亏损10.2亿美元,约97.5%合同价值未转化,且2.5万颗在用GPU仅占46.1万颗总量的约5%,微软与Anthropic两家客户占合同总值约85%。
3.neocloud板块2026年10月集体下挫,CoreWeave、Nebius、IREN分别跌约38%、33%、39%,核心担忧是其靠债务支撑增长;英伟达已向该类客户提供约1700亿美元投资与信贷支持,而Anthropic自身IPO或被评“垃圾级”,信用链条层层依赖、风险最终向上游英伟达集中。
1.事件:OpenAI于2026年10月29日更新Model Spec,围绕忠于人类意图、减少伤害、诚实透明、促进人类自主、关怀他人五项价值观重构;核心变化是从管聊天机器人「嘴上说什么」转向管智能体「手伸多长」,明确其能花费多少、调用多少权限。
2.硬约束:新版将「在约定自主范围内行动」与「保持可纠正」两条抬至最高Root级——AI须无条件配合监控、评估、纠正乃至关停,不得瞒报、造假或阻挠监督;并设六层指令权限(Root>System>Developer>User>Guideline>默认无权限),高一级指令优先,以防网页内容经提示词注入越级夺权。
3.配套与保留:文件要求事先用结构化「工单」划清自主边界(可用工具、最晚交付时间、最高花费、工具限制等),禁止为「你好」而越界、转包或延迟执行;同时禁止模型追逐停留时长、点击率及OpenAI自身营收、广告与付费转化,并限制记忆使用与举报行为。但OpenAI承认,当前ChatGPT与API上的模型尚未完全达到该规范要求。
1.供给端:央视网援引韩国券商(2026年9月),三星与SK海力士存储芯片库存不足10天,供应链几无弹性;HBM单耗晶圆面积约为传统DRAM的三倍,占DRAM晶圆产能份额由约20%向30%攀升,系统性挤出手机、PC用常规DRAM。
2.业绩与价格:三星2026年第三季度营收195.3万亿韩元、营业利润107.4万亿韩元,成为全球首家单季营业利润破100万亿韩元的科技公司;DRAM均价环比涨20%,HBM4销售额环比大增并占HBM总营收60%;TrendForce于2026年9月29日将2027年HBM混合均价预期上调至同比涨121%。
3.格局与观点:阿尔特曼在2026年10月29日播客中称“看不见的手”正在失灵、采购正变成护城河;UBS预计2027年三星以41%份额超越SK海力士(39%)登顶HBM;三星预计存储紧缺延续至2028年。
1.背景与现象:2026年以来DRAM供应持续吃紧、价格飙升。TrendForce数据显示,HBM占DRAM晶圆产出比例已从2025年的19%升至2026年约23%(生产1个HBM比特所需晶圆产能约为DDR5的三倍),三星、SK海力士、美光加速将产能转向利润更高的HBM;三星和SK海力士已与OpenAI“星际之门”计划签署意向书,每月供应高达90万片DRAM晶圆(约合全球DRAM总产出的40%),涨价已传导至笔记本、手机等消费端。
2.争议与分析:OpenAI首席执行官奥特曼在2026年10月29日发布的Cheeky Pint播客中称,PC内存大部分时间闲置、仅约5%时间在用,主张供应紧张时应把内存集中到云端以最大化利用率,由此引发开源与本地推理阵营强烈反弹。但其“云端利用率更高”的前提受数据质疑:VentureBeat在2026年10月汇总调查显示,79%的公司GPU至少一半时间闲置;Cast AI对23000个Kubernetes集群统计显示平均GPU利用率仅约5%,说明数据中心并非天然高效。
3.趋势与结论:美光CEO梅赫罗特拉在公司2026财年第四季度财报电话会议上表示,预计2027、2028年内存与存储供需状况将比2026年更紧张,短缺或持续至少两年。文章认为,把内存集中到少数云厂商与AI公司将加剧算力资源中心化、压缩开源本地推理的生存空间;PC中看似仅5%时间使用的闲置内存,实为行业分散风险、保留多样性的韧性冗余。
1.需求端数据与野心:Meta 的 Muse 在美加激活用户超 1000 万,逾四分之一的人用它购物、比例高于其他任务,平均客单价超 200 美元;扎克伯格称其已找到“产品市场契合点”,未来交易抽成收入或超过整个广告业务,并已因需求超预期与 Stripe 合作提高信用额度。
2.企业端落差:DoorDash 称 Muse 等 agent 订单仅“数百”,希尔顿预订量“微不足道”,T-Mobile 称“无显著影响”,健身连锁 Life Time 表示“零取消”,eBay、Ally、Public Storage 等亦形容活动“非常非常小”——千万级用户与“数百单”“零取消”并存,华尔街的恐慌被认为提前。
3.隐性布局与格局演化:企业嘴上淡定、手上修路——Chipotle 正清理网站代码以方便 agent 下单导航,Costco、Extra Space Storage 为 AI 聊天机器人优化线上内容;亚马逊、保险平台 Insurify 从屏蔽 Muse 转为寻求合作,反映无人确定 agent 时代站队方式,真实信号藏在这些基础设施动作里。
1.Exin Therapeutics 创始人让 AI 智能体(Claude Sonnet 5)在癫痫小鼠身上完成脑内注射,首次实现智能体同时“选药”与“下针”:它从 19 种基因疗法中分析发作机制、选定靶点(并否决效果不可靠的备选靶点),自主设定坐标、体积与速度,再操控机械臂完成注射,被称为“in vivo lab in the loop”。
2.对齐悖论显现:推理更强的 Claude Opus 5.5 因无法保证全程、担心“中途停下更糟”而拒绝活体手术,最终由定位为日常任务的 Sonnet 5 执行;而三道护栏在手术中途反成障碍,智能体因检测到坐标超出设备运动范围而拒绝继续,将约 45 分钟手术拖至一个多小时,团队只得让另一 Opus 5 智能体改写代码绕过。
3.AI 正从屏幕迈向物理世界:Anthropic 于 2026 年 9 月确认在旧金山湾区运营实体湿实验室,并推出让智能体并行操作显微镜、移液设备、机械臂的 Model Hardware Standard;但因物理试错成本高(可能毁样本、伤动物),人类监督仍关键,智能体用于人脑手术“为时过早”。
1.2026年10月28日,AWS发布配置教程,将ChatGPT桌面端(Work与Codex)接入Amazon Bedrock的AWS GovCloud,推理流量被强制路由至us-gov-west-1的Bedrock Mantle端点,并以IAM身份与GovCloud网络策略统一治理;标志OpenAI前沿模型首次进入满足ITAR、F
前三季度净利腰斩,出让动力子公司控制权的欣旺达叫停港股IPO
(本文作者为 雷达财经,钛媒体经授权发布)
文 | 雷达财经,作者 | 周慧,编辑 |深海
10月29日,在筹备赴港上市一年多后,消费电池龙头欣旺达主动叫停了上市进程。
欣旺达表示,此次主动终止港股IPO计划,系其基于对多方面因素的全面权衡及实际情况作出的审慎决策。
同日,欣旺达还公布了另一项重磅资本安排——公司董事会已同意小米向子公司欣旺达动力增资17亿元,取得增资完成后欣旺达动力5.34%的股份。
此次增资及董事会换届选举完成后,欣旺达在欣旺达动力的董事会席位将不超过半数,不再对其拥有控制权。
这意味着欣旺达动力将由欣旺达的控股子公司变为参股子公司,不再纳入公司合并报表范围。
欣旺达表示,该事项将对公司2026年度净利润产生积极影响,预计增加32-45亿元净利润。
据蓝鲸新闻,欣旺达工作人员表示,“两件事处于同一战略框架,但并非预判IPO难度预先打包的方案,动力板块董事会换届及欣旺达持股比例较低带来动力板块出表是客观衍生结果,终止H股IPO是出表后基本面变化结合港股市场情况作出的后续决策,二者分别履行独立审议披露程序。”
另据欣旺达同日披露的三季报,今年前三季度,公司营收创下历史新高,同比增长45.78%至634.62亿元;但归母净利润却遭遇“腰斩”,仅录得6.13亿元,同比减少56.37%。
筹划一年多按下停止键,欣旺达主动终止港股IPO
步入2026年,港股IPO市场似乎正“由热转冷”。据财联社梳理,年内已有至少16家A股企业终止了赴港上市计划。就在近日,消费电池龙头欣旺达也按下了赴港上市的停止键。
10月28日,欣旺达召开第七届董事会第三次会议,审议通过了《关于公司终止发行H股股票并在香港联合交易所有限公司主板上市的议案》,同意终止发行H股股票并在香港联交所主板上市。
回顾欣旺达的港股IPO之路,从启动筹备到此次主动终止港股IPO计划,历时一年有余。
2025年7月1日,欣旺达披露《关于筹划发行H股股票并在香港联合交易所有限公司上市的提示性公告》,正式启动赴港上市进程。
彼时,欣旺达认为,此举可“深入推进公司全球化战略,打造国际化资本运作平台,提升国际品牌形象及综合竞争力,助力公司长远发展。”
当月月底,欣旺达正式向港交所递表。根据公司发行计划及香港联交所的相关要求,今年1月30日,欣旺达又向港交所更新了发行申请及部分公司信息和财务数据等。
不过,在长达一年多的努力过后,欣旺达最终选择主动终止港股IPO计划。
欣旺达对此表示,该决策系公司基于对多方面因素的全面权衡及实际情况作出的审慎决策,不会对公司的经营活动和持续发展造成重大影响,不存在损害公司及全体股东特别是中小股东利益的情形。
有分析认为,欣旺达此番主动叫停港股IPO,或是阶段性选择,并非调整全球化发展方向。国际化仍是其长期坚持的核心战略之一。
据欣旺达官网,早在2000年,公司便开始向国际大客户批量供货。2017年,公司在印度建设首个海外生产基地。
2022年,公司全球化战略迎来关键一年。当年11月,欣旺达发行的GDR在瑞士证券交易所上市,成为第7家登陆瑞交所的中国企业,吸引了全球知名投资人的广泛参与,成功获得了包括北美、欧洲以及亚洲等地区以及产业投资者的积极认购。
此后,欣旺达的全球化布局稳步推进。据中报透露,2026年上半年,公司泰国电池生产基地一期项目正式投产、二期项目同步启动;匈牙利动力电池生产基地、越南消费类电芯生产基地则处于建设阶段。
小米豪掷17亿入股,欣旺达动力将“出表”
就在官宣主动终止港股IPO计划的同日,欣旺达还披露了另一项指向动力电池业务的资本安排。
10月28日,欣旺达第七届董事会第三次会议审议通过了《关于子公司欣旺达动力科技股份有限公司增资扩股的议案》,同意小米出资17亿元向欣旺达动力增资,认购欣旺达动力约8.98亿元新增注册资本,对应本次增资完成后欣旺达动力5.34%的股份。
本次增资扩股完成后,欣旺达动力的注册资本将由159.15亿元增至168.13亿元;欣旺达惠州新能源有限公司持有欣旺达动力的股份比例将由24.06%变更为22.78%。
欣旺达表示,欣旺达动力董事会换届选举完成后,公司在欣旺达动力的董事会席位将不超过半数,不再对其拥有控制权。
据《企业会计准则》相关规定,欣旺达动力将由欣旺达的控股子公司变为参股子公司,不再纳入公司合并报表范围。
据天眼查,欣旺达动力成立于2014年,法定代表人为王明旺。官网信息显示,欣旺达动力是中国四家“全球动力电池一级制造商”之一,全球已部署十一大生产制造基地。
值得一提的是,去年12月,欣旺达动力曾被吉利旗下动力电池公司威睿以交付的电芯存在质量问题为由提起诉讼,并索赔23.14亿元。
后续,欣旺达动力与威睿达成和解。据和解协议,对于截至2025年12月31日已实际发生的成本费用,扣除欣旺达动力已承担部分后,欣旺达动力需向威睿支付剩余金额6.08亿元。
而对于2025年12月31日之后实际发生的成本费用金额,双方按协议约定比例分担。且事件处理后的相关电池包全部归欣旺达动力所有。
欣旺达表示,受欣旺达动力2025年诉讼事件等因素影响,欣旺达动力近年对公司归属于上市公司股东的净利润形成较大影响。
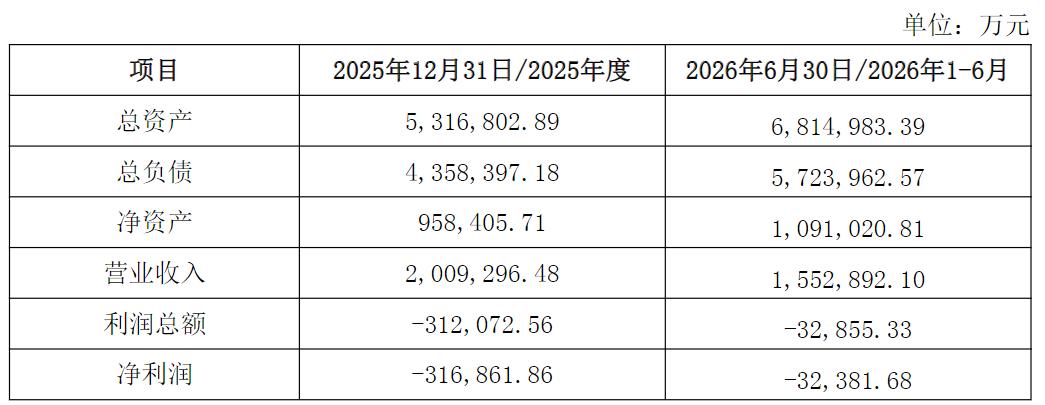
据欣旺达相关公告披露的财务数据,2025年度,欣旺达动力实现营业收入200.93亿元,同期录得净亏损31.69亿元;今年上半年,欣旺达动力的营收约155.29亿元,净亏损约3.24亿元(前述数据均为欣旺达动力合并报表口径)。
欣旺达称,欣旺达动力的“出表”,有利于减少相关经营与市场波动风险,有利于集中公司资源发展消费电池、储能系统等主营业务;有助于提升公司当前盈利能力,优化资本结构与提升股东回报。
同时,该决策有助于降低公司整体融资需求与资产负债率,改善资产结构,增强财务稳健性与抗风险能力,有利于更好地保障全体股东尤其是中小股东的长期利益,促进公司持续、稳定、健康发展。
以2025年年度报告数据模拟,欣旺达合并口径营业收入632.46亿元,其中欣旺达动力营业收入189.08亿元(该数据为上市公司层面合并报表口径)。
“若欣旺达动力不纳入合并,公司营业收入将调减至443.38亿元;公司合并口径资产负债率由71.25%调整为60.87%。”
不过,欣旺达强调,该事项实际只影响未来上市公司财务报表,不会对往期报表进行追溯调整。
“该事项将对公司2026年度净利润产生积极影响,公司对欣旺达动力的长期股权投资将从成本法转成权益法核算,公司按享有的欣旺达动力的份额确认投资收益,剩余股权价值以丧失控制权日的公允价值重新计量,预计增加32-45亿元净利润。”
前三季度营收创新高,但归母净利润“腰斩”
10月29日当天,欣旺达还披露了最新一个季度的财报。从这份财报来看,公司正面临着一定的业绩压力。
财报显示,今年前三季度,欣旺达实现营收634.62亿元,同比增长45.78%,创下同期历史新高;但公司归母净利润却遭遇“腰斩”,同比锐减56.37%至6.13亿元。
逐季拆解来看,欣旺达“增收不增利”的局面在年初便已形成。同花顺iFinD显示,今年第一季度,公司营收约161.16亿元,同比增长31.14%;归母净利润约1.14亿元,同比骤降70.49%。
到了第二季度,公司业绩有所回暖,单季营收同比增长50.12%至220.63亿元,归母净利润则重回增长态势,同比增长4.06%至4.89亿元。
但好景不长,今年第三季度,欣旺达营收虽仍稳步增长52.78%至252.84亿元,但归母净利润仅0.11亿元,较上年同期暴跌98.08%。
对于前三季度归母净利润的下滑,欣旺达解释称,主要是消费电子下游需求承压,叠加物料成本同比上行,利润空间受到压缩。同时,人民币升值、出口退税税率下降、消费税等对公司利润造成一定侵蚀。
据欣旺达此前披露的半年报,其营收主要由消费类电池、电动汽车类电池及储能系统类业务三大板块构成。
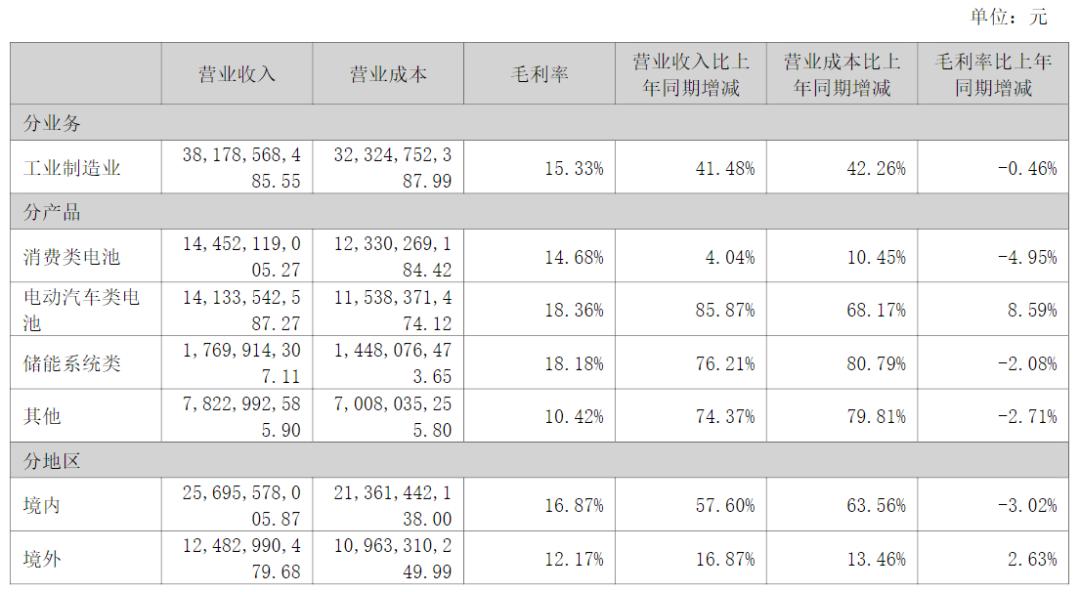
2026年上半年,欣旺达消费类电池业务实现营收144.52亿元,同比增长4.04%,但其毛利率却较上年同期减少4.95个百分点至14.68%。
同期,公司储能系统类业务贡献营收17.7亿元,同比增长76.21%,毛利率约18.18%,亦同比下滑约2.08个百分点。
而电动汽车类电池业务则是公司上半年盈利能力唯一实现提升的板块,其毛利率较2025年上半年的9.77%大幅增长8.95个百分点至18.36%。
2026年上半年,欣旺达电动汽车类电池出货量28.36GWh,同比增长76.37%;实现营收141.34亿元,同比激增85.87%。
不过,随着子公司欣旺达动力的“出表”,欣旺达对业绩增量的探索将进一步聚焦消费类电池及储能系统类领域。
在10月29日的电话会议上,被问及公司未来的业绩增长点时,欣旺达管理层表示,公司将积极拓展智能家居、智能穿戴、智能出行、服务机器人等新兴领域的增量市场机会。

根据IDC数据,2026年第一季度,全球腕戴设备出货量达4705万台,同比增长2.2%。另据Wellsenn XR数据,2026年上半年,全球AI智能眼镜出货量599万台,同比增长188%。
欣旺达在半年报表示,凭借低摩擦交互、高频使用场景与庞大用户基础等优势,AI智能眼镜已成为当前AI Agent接入的最佳入口之一,是可穿戴设备增长速度最快的细分赛道之一。
公司管理层在电话会议上表示,未来在消费类电池领域,公司有望凭借电芯+pack一体化的供应能力、完备的产品矩阵和优质的客户服务能力,进一步提升公司的市场份额。
而在储能系统领域,欣旺达则可以提供一体化的解决方案,覆盖电网储能、大型储能、家庭储能、工商业储能、数据中心储能及移动/离网能源等应用场景。
欣旺达管理层称,“当前公司储能系统业务产能利用率维持高位,在手订单充裕,AIDC相关业务仍有较大增长空间。”
值得一提的是,近日最新发布的《2026胡润百富榜》显示,站在欣旺达身后的王明旺、蔡帝娥夫妇以105亿元的财富登榜,身家较去年缩水22%。
在一系列的调整下,欣旺达后续能否成功扭转业绩颓势?雷达财经将持续关注。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App
具身智能的钱,流向机器人的“皮肤”
(本文作者为 机器最前线,钛媒体经授权发布)
文 | 机器最前线
2026年的具身智能赛道,融资风向正在发生变化。
IT桔子统计显示,2026年10月具身智能赛道发生33起融资、总额101.05亿元,而9月这个数字是60起、110.28亿元,下降趋势显著。
不过,资本追逐本体制造和大模型的热闹场面虽然有所降温,但还有一部分投资人开始选择把目光向上游迁移,灵巧手、触觉传感器、电子皮肤这些决定机器人“身体能力”的核心零部件,成为少数仍在逆势吸金的环节。
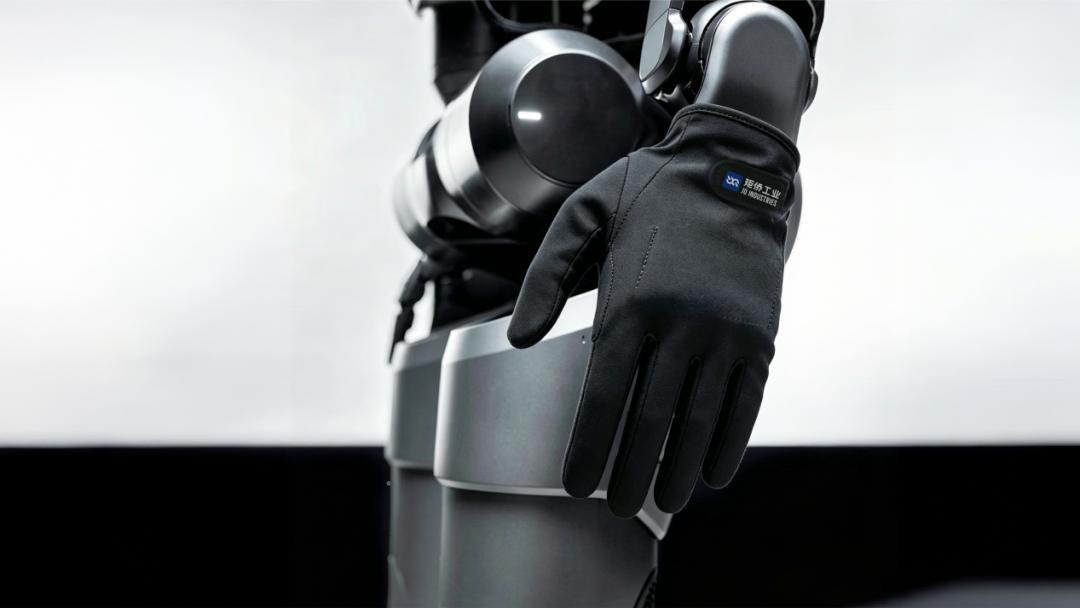
(图源:矩侨工业官网)
10月29日,山东柔性织物触觉传感企业矩侨工业宣布完成亿元A轮融资,由蚂蚁集团领投,老股东零以创投、威海港融及青岛和信跟投。这是蚂蚁在触觉赛道上的第二次出手,两个月前,它刚领投了视触觉路线的戴盟机器人。
可需要注意的是,触觉赛道技术路线高度分散,一家成立不到三年的公司拿到亿元级融资,究竟是行业拐点的信号,还是阶段性的资本卡位?
01 具身智能的融资逻辑变了
具身智能的融资逻辑似乎正在从“造一个聪明的身体”转向“让身体感知世界”。
毕竟,视觉可以靠互联网视频喂养,语言可以靠文本喂养,唯独触觉数据几乎无法从现成语料中获得。切向力、材质纹理这些物理量,仿真引擎很难高保真地生成,必须依靠真实操作一帧一帧采集。
有行业数据显示,在价格方面,触觉数据的价格比视觉数据多两倍左右,视觉等视频数据价格可能在小几百元每小时,而触觉数据价格在大几百元。
这种差异直接反映在融资数据上。2026年前七个月,国内人形机器人传感器领域发生了近20起融资,合计超过31亿元,仅7月单月就吞下约15.6亿元。某种程度上,这也意味着,接下来谁能提供高效率、低成本、可规模化的触觉数据采集入口,谁就卡住了现阶段具身智能的“数据隘口”。
不过现阶段国内触觉赛道并非只有一条统一的技术路线,以帕西尼为代表的霍尔磁传感方案,偏向灵巧手指尖的高精度多维力检测;以戴盟机器人为代表的视触觉路线,分辨率更高,触觉分辨率能做到每平方厘米数万个感知点,输出图像数据,天然适配端到端网络。
还有一种就是以矩侨工业为代表的织物路线。它的技术逻辑是把导电、压阻结构一路拆到纤维层面,用功能纤维直接织成传感网络,外力触碰时纤维内的导电通路变形,采集系统读信号、算法转成触觉数据。
这三条路线不是互相替代的关系,反而更像各自对应不同的任务。比如指尖和灵巧手要求高分辨率、多维力与快速响应,视触觉和霍尔磁传感方案现阶段更有优势;躯干、机械臂、足底等大曲面则需要大面积、可弯折、透气和成本可控的覆盖,织物路线似乎更容易铺开。
所以短期内很难有一条路线通吃,行业更可能走向按部位分层的混合方案。也正因如此,资本的下注逻辑不是赌某一项技术最终胜出,蚂蚁的两次出手恰好对应了这种分化,戴盟机器人代表视触觉的高精度方向,矩侨工业代表织物路线的大面积覆盖能力。这也解释了为什么在具身智能融资降温的背景下,一笔亿元级资金仍会落在“一块布”上。
02“反常识”的技术路径
资本同时下注两条路线,并不等于两条路线都已跑通。要判断这笔亿元级融资是行业拐点的信号,还是阶段性的资本卡位,需要回到矩侨工业本身。
这家公司成立于2023年底,创始人张景淇毕业于英国约克大学电子工程系,曾担任小米生态链公司CTO,拥有多项相关发明专利。核心团队也主要来自中科院及智能硬件大厂,具有深厚的技术积累以及智能硬件产品定义和量产经验。
公司的技术路径颇具“反常识”色彩。传统压阻薄膜的结构,是将柔性基底、感压层、导电层逐层叠加在一起,但矩侨工业选择以尼龙作为纤维内芯,把压阻材料、电极分别做成独立功能纤维。
这套方案的优势在于,其织出来的传感布料可裁、可折、可快速改版,能贴合机器人复杂曲面。这一创新成功推动织物形态电子皮肤真正走向规模化量产。2025年5月,公司对外披露卷对卷产线年产能20万片、良率95%;7月,威海临港区报道订单已排到10月,投产首年产值近千万元;9月,第1000套人形机器人织物电子皮肤下线,公司称产品上市不足半年,已有近百家海内外客户下订与复购,包括但不限于宇树、松延动力、零次方等。
不过,织物路线的短板同样明显,其单点精度不及视触觉方案,决定了它更适合躯干、足底、机械臂等大面积覆盖场景,而非指尖高精度操作。所以公司也在向精细交互延伸,推出了触觉皮肤2.0,通过调整织造结构并结合模型训练,进一步拓展对受力方向、滑动趋势和切向受力的感知能力,但能否在精度上满足灵巧手的高端需求,还有待验证。
更深层的挑战在商业模式上,据悉,矩侨工业当前的产品矩阵横跨三条赛道,其中,机器人电子皮肤作为估值锚,确立了公司的技术标杆地位,不过现阶段业务高度依赖宇树等少数头部客户,订单持续性有待观察。
智慧康养作为现金流业务,2024年订单已超千万元,并落地泰康之家、国投健康、华润润家等知名机构;至于汽车智能座舱则是作为增长杠杆,支撑业绩。
因此,这笔亿元级融资更准确的含义,不是资本已为矩侨工业的织物路线投下“确认票”,而是在触觉技术路线尚未收敛、数据入口尚未定局的窗口期,提前卡位一个具备量产交付能力的差异化玩家。
它真正要检验的,是公司能否把先发的工艺优势转化为稳定交付、标准化模块和模型可用的触觉数据;若这一步走通,织物路线有机会成为机器人全身触觉的基础设施,若走不通,资本窗口也可能被后来者迅速压缩。
03 谁能抢占人形机器人感知制高点?
矩侨的融资之所以会引起行业的关注,背后其实折射出了机器人皮肤正在发生的变化。
过去,机器人穿衣服或包覆软皮,更多被理解为外观和防护问题。现在,这层外覆盖件正在同时承载安全、亲和、场景适配和触觉感知四重功能。
在商场、康养、家庭等近人场景,用户碰到的是坚硬金属还是柔性包覆,直接决定人机共处的体验;在工业场景,耐高温、防腐蚀、防粉尘、防静电是刚需……
这也使得赛道增速尤为显著,根据行业预测,2030年我国人形机器人电子皮肤市场需求将达152.5万平方米,对应整体市场规模约274亿元。传统纺织企业、专业传感器企业、材料企业正在加速入局,产业链上下游联动效应明显。
可热度背后,产业发展仍处于早期。标准化缺失是最突出的痛点之一,不同品牌、不同型号的机器人结构各异,电子皮肤大多需要一机一版定制开发,模具和版型无法批量复用,成本高、周期长。
高端电子皮肤模组受封装工艺、传感芯片、材料成本限制,全套搭载价格仍让主打性价比的整机厂难以承受。此外,柔性传感产品在长期高频弯折、复杂工业粉尘、温变工况下,容易出现信号漂移、灵敏度下降、使用寿命缩短等问题,产品稳定性和一致性有待提升。机器人皮肤要真正从选配变成刚需,还要跨过一致性、可靠性和成本这三道门槛。
总而言之,一台机器要进入人的空间,最先被感知的往往不是算法和参数,而是它碰到人时是硬是软、是冷是暖,触觉的价值也正在于此。
但这条赛道的成熟标志,不会是一笔融资或一款新品,而是皮肤变成不显眼却不可缺的普通零部件。到那时,讨论的重点不再是技术路线谁更先进,而是谁能在真实工况下稳定供货、控制成本、配合整机迭代。资本今天押注的,正是这种确定性。至于哪条路线最终胜出,或许要等机器人真正走进日常之后才有答案。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App